
در هوش مصنوعی (AI) و یادگیری ماشین (Machine Learning یا ML)، داده ستون فقراتی است که همهچیز بر آن استوار است. بدون داده، حتی پیشرفتهترین الگوریتم هم نه چیزی برای یاد گرفتن دارد و نه مبنایی برای پیشبینی. این مطلب به انواع داده در هوش مصنوعی، اهمیت کیفیت داده و نقش پیشپردازش در تبدیل داده خام به چیزی که مدل بتواند از آن یاد بگیرد میپردازد.
انواع داده
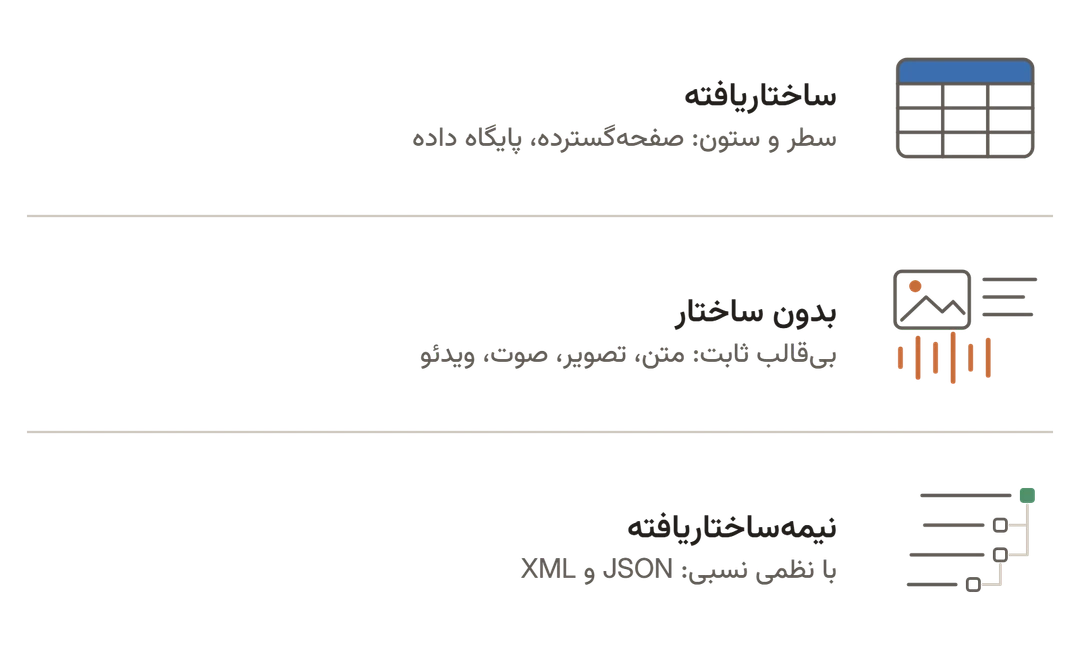
دادهها در هوش مصنوعی معمولاً سه نوعاند: ساختاریافته (Structured)، بدون ساختار (Unstructured) و نیمهساختاریافته (Semi-structured). هر نوع کاربرد خودش را دارد و شیوه کار با آن متفاوت است.
داده ساختاریافته
داده ساختاریافته بسیار منظم است و معمولاً مثل صفحهگسترده یا پایگاه داده در قالب سطر و ستون ذخیره میشود. چند نمونه:
- مقادیر عددی، مثل قیمت، قد و سن
- مقادیر دستهای، مثل «بله» یا «خیر»، نوع محصول و مکان
داده بدون ساختار
داده بدون ساختار قالب ثابتی ندارد و شکلهای گوناگونی دارد:
- متن، مثل ایمیل و نوشتههای شبکههای اجتماعی
- تصویر، مثل عکس و تصاویر پزشکی
- فایلهای صوتی و ویدئویی
داده نیمهساختاریافته
داده نیمهساختاریافته جایی میان این دو قرار میگیرد: تا حدی نظم دارد، اما نه به اندازه داده ساختاریافته. چند نمونه:
- فایلهای JSON که برنامههای وب برای تبادل داده از آنها استفاده میکنند
- فایلهای XML که اغلب برای ذخیره اسناد به کار میروند
چرا کیفیت داده مهم است
در یادگیری ماشین جمله معروفی هست: «ورودی بیارزش، خروجی بیارزش» (Garbage in, garbage out). یعنی مدلی که با داده بیکیفیت آموزش ببیند، پیشبینیهای غیرقابلاعتمادی خواهد داشت. کیفیت داده بر دقت و کارایی مدل اثر میگذارد و میتواند سرنوشت یک پروژه را رقم بزند. چهار جنبه آن را باید در نظر داشت:
- درستی: داده باید شرایط دنیای واقعی را بازتاب دهد.
- کامل بودن: مقادیر گمشده میتواند به پیشبینیهای سوگیرانه بینجامد.
- سازگاری: داده نباید با خودش تناقض داشته باشد؛ مثلاً برای یک نفر دو تاریخ تولد ثبت نشده باشد.
- ارتباط: داده نامرتبط میتواند مدل را گمراه کند و دقتش را پایین بیاورد.
آمادهسازی داده برای یادگیری ماشین
کمتر پیش میآید که داده خام آماده استفاده باشد. ابتدا باید از مرحله پیشپردازش (Preprocessing) بگذرد که آن را پاکسازی، قالببندی و برای یادگیری بهینه میکند. جزئیات کار به نوع و کیفیت داده بستگی دارد، اما چهار گام در بیشتر موارد مشترک است.
پاکسازی داده
پاکسازی، نادرستیها و ناسازگاریها را از مجموعهداده حذف میکند و این کارها را در بر میگیرد:
- رسیدگی به مقادیر گمشده: جایگزین کردن یا حذف آنها داده را کامل نگه میدارد.
- رسیدگی به دادههای پرت: مقادیر بسیار دور از بقیه، اگر به حال خود رها شوند، میتوانند پیشبینیهای مدل را منحرف کنند.
- یکدست کردن قالبها: استفاده از واحدها و قالب تاریخ یکسان در سراسر داده از بروز خطا جلوگیری میکند.
تبدیل داده
در این گام، داده به شکلی درمیآید که مدل بتواند با آن کار کند؛ برای نمونه:
- مقیاسبندی و نرمالسازی: آوردن مقادیر به بازهای مشترک، مثلاً ۰ تا ۱، تا با هم قابل مقایسه باشند.
- کدگذاری دادههای دستهای: تبدیل برچسبهای متنی، مثل «گربه» یا «سگ»، به عدد تا مدل بتواند آنها را پردازش کند.
مهندسی ویژگی
مهندسی ویژگی (Feature Engineering) از دادههای موجود ویژگیهای تازهای میسازد تا مدل بهتر عمل کند. برای نمونه، از ستون «تاریخ» میتوان ویژگیهایی مثل «روز هفته» یا «ماه» به دست آورد.
تقسیم داده
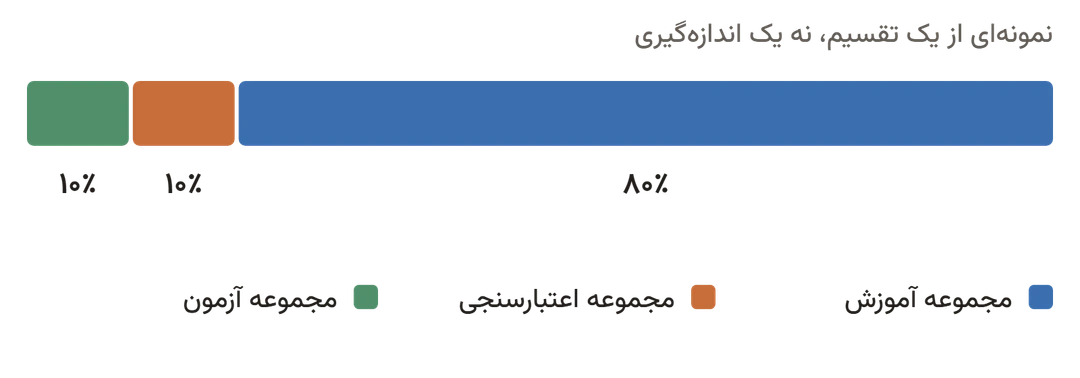
در پایان، داده معمولاً به سه بخش تقسیم میشود:
- مجموعه آموزش: برای آموزش مدل.
- مجموعه اعتبارسنجی: برای تنظیم و ارزیابی مدل در حین آموزش.
- مجموعه آزمون: برای سنجش عملکرد مدل روی دادههایی که پیشتر ندیده است.
داده بهتر، مدل بهتر
داده در موفقیت هوش مصنوعی و یادگیری ماشین نقشی بنیادین دارد. دادهای که کیفیت بالایی دارد و خوب آماده شده است به مدلهایی میانجامد که دقیق پیشبینی میکنند و بینشهای سودمندی به دست میدهند. شناخت انواع داده و گامهای اصلی پیشپردازش، نخستین قدم برای یک پروژه موفق هوش مصنوعی است. هرچه دادههایتان بهتر باشد، مدلتان هم بهتر خواهد بود.