
- اپ پژوهشی: باز کردن اپ (در زبانه تازه باز میشود) (اولین اجرا ممکن است چند دقیقه طول بکشد)
- کد و گزارشها: مخزن پروژه در GitHub (در زبانه تازه باز میشود)
خلاصه
آیا یک مدل یادگیری ماشین میتواند نتیجه بازیهای جام جهانی را بهتر از Eloامتیاز Eloنمرهای برای قدرت نسبی هر تیم که از شطرنج آمده است. هر تیم از ۱۵۰۰ شروع میکند و بعد از هر بازی، امتیازش بر اساس فاصله نتیجه واقعی با نتیجه مورد انتظار تغییر میکند؛ پس حتی تساوی هم میتواند امتیاز را جابهجا کند.دیدن در واژهنامه پیشبینی کند؟ Elo امتیاز سادهای است که قدرت نسبی هر تیم را از روی نتایج گذشتهاش نشان میدهد. برای اینکه جواب را پیدا کنم، برای جام جهانی ۲۰۲۶ مدلی ساختم که پیش از هر بازی سه احتمال میدهد: برد تیم اول، تساوی و برد تیم دوم. برای محاسبه این سه احتمال، خروجی XGBoostXGBoostروشی از یادگیری ماشین که صدها درخت تصمیم کوچک را پشت سر هم میسازد و هر درخت خطای درختهای قبلی را اصلاح میکند.دیدن در واژهنامه را با برآورد Eloبرآورد اولیه بر پایه Elo (prior)برآوردی از احتمال برد، تساوی و باخت بر اساس امتیاز Elo دو تیم. در این پروژه، این برآورد ۲۵ درصد وزن پیشبینی نهایی را دارد.دیدن در واژهنامه ترکیب کردم. این مدل تعداد گلها را هم پیشبینی میکند، هر پیشبینی را به زبان ساده توضیح میدهد و کل جام را شبیهسازی میکند. همه اینها در یک اپ عمومی کوچک در دسترس است. (اگر بعضی از این نامها برایتان تازه است، واژهنامه پایان مقاله هر کدام را در یک خط توضیح میدهد.)
مدل را دو بار آزمودم: یک بار روی سه جام جهانی گذشته (۱۹۲ بازی، با امتیاز و فرم تیمها که در طول هر جام ثابت ماند) و یک بار روی هر ۱۰۴ بازی جام جهانی ۲۰۲۶. دادههای آموزشی برای جام ۲۰۲۶ تا ۱۰ ژوئن، یک روز پیش از بازی افتتاحیه، بود.
هیچکدام از دو آزمون برنده روشنی نداشت. در سه جام گذشته، Elo نتیجه بازیهای بیشتری را درست پیشبینی کرد (۵۶٫۲۵ درصد در برابر ۵۳٫۱ درصد)، اما آزمون جفتی این تفاوت را معنادار ندانست (p = 0.21مقدار p (p-value)اگر دو مدل واقعاً دقت یکسانی داشته باشند، احتمال اینکه در آزمون اختلافی به این بزرگی یا بزرگتر ببینیم. در این مقاله از آزمون مکنمار به دست آمده است.دیدن در واژهنامه). از ۱۰۴ بازی جام ۲۰۲۶ هم مدل من نتیجه ۶۸ بازی را درست پیشبینی کرد و Elo نتیجه ۷۰ بازی را. با این حال وقتی احتمال هر سه نتیجه را در نظر گرفتم، مدل من log-losslog-lossمعیاری برای پیشبینیهای احتمالی که پیشبینی مطمئن و درست را تشویق و پیشبینی مطمئن و غلط را بیشتر جریمه میکند. عدد کمتر بهتر است.دیدن در واژهنامه کمتری داشت و این بار بازهبازه اطمینان (confidence interval)بازهای که عدمقطعیت یک برآورد را نشان میدهد. در این مقاله، اگر بازه اختلاف دو مدل صفر را در بر بگیرد، دادهها با نبود اختلاف هم سازگارند.دیدن در واژهنامه بوتاسترپبوتاسترپ جفتی (paired bootstrap)هزاران بار از همان بازیها با بازگرداندن نمونه میگیریم؛ یک بازی ممکن است در یک نمونه چند بار تکرار شود. هر بار هر دو مدل روی همان نمونه مقایسه میشوند تا ببینیم اختلاف امتیازشان چقدر تغییر میکند. در این مقاله، بازه تفاوت log-loss دو مدل را با این روش حساب کردم.دیدن در واژهنامه این تفاوت صفر را در بر نمیگرفت. log-loss به زبان ساده میسنجد مدل به نتیجهای که واقعاً رخ داد چقدر احتمال داده بود؛ عدد کمترش بهتر است.
زمان ثبت پیشبینیها هم مهم است. فقط چهار پیشبینی آخر پیش از شروع بازی ثبت شد؛ سه تا درست درآمد و Elo هم همان چهار تیم را انتخاب کرده بود. ۱۰۰ پیشبینی دیگر را بعد از جام، با همان دادههای آموزشی تا ۱۰ ژوئن، دوباره حساب کردم. بقیه این مقاله توضیح میدهد چرا نزدیک شدن به یک مدل مبنای ساده آموزندهترین نتیجه این پروژه بود و این نتیجه درباره پیشبینی فوتبال از روی سابقه عمومی بازیها چه میگوید.
چرا پیشبینی نتیجه فوتبال دشوار است؟
دشواری پیشبینی فوتبال به ساختار خود بازی برمیگردد. هر بازی سه نتیجه ممکن دارد و بخشی از دشواری به تساوی برمیگردد: در سابقه طولانی لیگ انگلیس تقریباً یکچهارم بازیها مساوی تمام شده و بازیهای ملی هم با نرخی مشابه یا کمی کمتر مساوی میشوند. پس بخش بزرگی از هر مجموعهداده همان نتیجهای است که پیشبینیاش از همه سختتر است، و همین برای دقت هر مدل سهگزینهای سقفی میگذارد.
هر مدل فوتبال رقیب سختی هم دارد: بازار شرطبندی. فورست، گودارد و سیمونز (۲۰۰۵) نشان دادند که یک مدل آماری پیشرفته فقط به پای بنگاههای شرطبندی میرسد و بهطور پیوسته از آنها جلو نمیزند. پس سؤال یک پروژه شخصی این نیست که «میتوانم بازار را شکست بدهم؟»، بلکه این است که «میتوانم مدلی خوشساخت با احتمالهای قابل اعتماد بسازم و بفهمم حدش کجاست؟».
این همان سؤالی بود که برای جام جهانی ۲۰۲۶ دنبالش رفتم: اولین جام ۴۸ تیمی، به میزبانی مشترک آمریکا، کانادا و مکزیک از ۱۱ ژوئن تا ۱۹ ژوئیه ۲۰۲۶، با ۱۲ گروه چهارتیمی و یک مرحله حذفی تازه با ۳۲ تیم.
دادهها: چه میگویند و چه نمیگویند
پایه کار مجموعهداده نتایج بازیهای ملی فوتبال از ۱۸۷۲ (در زبانه تازه باز میشود) از مارت یوریسو (Mart Jürisoo) است: نزدیک به ۴۹ هزار بازی ملی رسمی مردان، از اولین بازی رسمی در سال ۱۸۷۲ تا امروز، با تاریخ، تیمها، گلها، نام مسابقه، محل بازی و اینکه زمین بیطرف بوده یا نه. بازیهای المپیک و بازیهای تیمهای B، زیر ۲۳ سال و تیمهای منتخب در آن نیست؛ برای مدلسازی تیمهای ملی بزرگسالان دقیقاً همین را میخواهیم.
سه نکته آنقدر مهم است که باید همین اول گفته شود.
نتیجه بازیهای حذفی. این مجموعهداده نتیجه را با احتساب وقت اضافه و بدون ضربات پنالتی ثبت میکند. بازیای که بعد از ۹۰ دقیقه یک بر یک بوده و بعد از وقت اضافه دو بر یک تمام شده، برد ثبت میشود، نه تساوی. پس سه نتیجهای که مدل من پیشبینی میکند این است: «نتیجه بعد از وقت اضافه، با بازیهایی که به پنالتی کشیده شده به عنوان تساوی». این به «چه تیمی صعود میکند» نزدیکتر است تا به نتیجه ۹۰ دقیقهای. برای مدل یک جام منطقی است، اما باید صریح گفته شود. ردیاب پیشبینی هم همین قرارداد را رعایت میکند و ضربات پنالتی را از نتایج دریافتی کنار میگذارد، تا بازی حذفیای که با پنالتی تمام شده، درست مثل دادههای آموزشی، تساوی بعد از وقت اضافه حساب شود.
منبع داده مدام بهروز میشود. مخزن منبع پیوسته تغییر میکند و حتی نتیجه بازیهای قدیمی هم گاهی اصلاح میشود. برای همین، نتیجهای که بشود دوباره به آن رسید به یک نسخه ثابت از داده نیاز دارد. همه عددهای این مقاله از یک فایل ثابت با ۴۹٬۴۰۴ بازی میآیند که آخرین بازیاش در ۱۰ ژوئن ۲۰۲۶ است. هش این فایل و هش مدل آموزشدیده در فایل manifest مخزن ثبت شده و اگر هر کدام از این دو فایل تغییر کند، یک آزمون خودکار شکست میخورد. تاریخ برش داده، هشها و نسخه مخزن منبع در مشخصات نسخه داده استفادهشده در این پروژه (در زبانه تازه باز میشود) آمده است.
هیچ اطلاعاتی از آینده، با دو استثنای اعلامشده. ویژگیهای هر بازی فقط از اطلاعاتی ساخته میشود که پیش از شروع آن بازی در دسترس بوده، و در ارزیابی روی جامهای گذشته، مدل هر جام فقط با بازیهای پیش از همان جام آموزش میبیند. دو عدد ثابت استثنا هستند: سهم تساوی در برآورد Elo و امتیازی که به تیم میزبان اضافه میشود. هر دو یک بار روی کل سابقه تا ژوئن ۲۰۲۶ برآورد شدهاند، پس در ارزیابی جامهای گذشته، بازیهایی را هم در بر دارند که بعد از آن جامها انجام شده است. اثر هر کدام و حدود بررسیاش را در بخشهای ویژگیها و مدل توضیح میدهم. این نکته بدیهی به نظر میرسد، اما سادهترین جایی است که کار بیسروصدا خراب میشود؛ بخش ارزیابی جایی را نشان میدهد که ارزیابی اول خود من با وجود همه این دقتها اشتباه کرده بود.
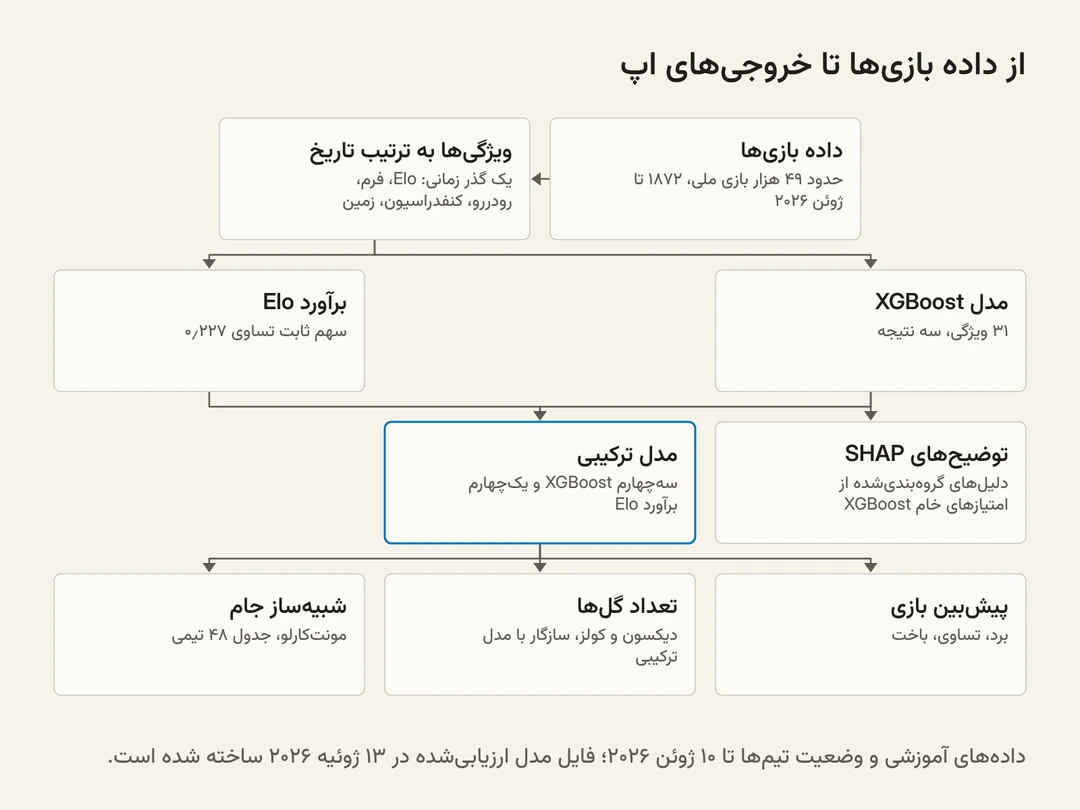
ویژگیها: Elo در مرکز، ساختهشده به ترتیب زمان
ویژگیها عمداً قابل تفسیرند و مهمترینشان امتیاز Elo هر تیم است. Elo از شطرنج آمده (Elo، ۱۹۷۸) و هر تیم را از ۱۵۰۰ شروع میکند. بعد از هر بازی، امتیاز هر تیم بر اساس فاصله نتیجه واقعی با نتیجه مورد انتظار تغییر میکند؛ پس حتی تساوی در برابر تیمی خیلی قویتر هم برای تیم ضعیفتر امتیاز میآورد. امتیاز مورد انتظار تیم میزبان از این منحنی لجستیک استاندارد به دست میآید:
و بعد از بازی، امتیاز هر تیم به اندازه فاصله نتیجه با انتظار جابهجا میشود:
در این فرمول S برای برد، تساوی و باخت میزبان به ترتیب ۱، ۰٫۵ و ۰ است. من K را ثابت و برابر ۴۰ گرفتم؛ یک سادهسازی عملی، نه مقداری که بهینه شده باشد. سیستمهای حرفهای Elo در فوتبال، مثل World Football Elo Ratings، مقدار K را بر اساس اهمیت بازی و اختلاف گل تغییر میدهند. K ثابت یعنی یک بازی دوستانه و فینال جام جهانی به یک اندازه در امتیاز اثر میگذارند. K را ثابت نگه داشتم چون Elo با همین شکل ساده هم مدل مبنای شفاف و قویای است و، همانطور که نتایج نشان میدهد، شکست دادنش به هر حال خیلی سخت است.
علاوه بر Elo، هر بازی این ویژگیها را هم دارد: فرم اخیر هر تیم (درصد برد و میانگین تفاضل گل در ۵ و ۱۰ بازی آخر)، سابقه رودررو (تعداد دیدارهای قبلی و درصد برد تیم اول در آنها)، قدرت کنفدراسیون (میانگین Elo تیمهای هر کنفدراسیون؛ در این دادهها میانگین امتیاز تیمهای یوفا و کونمبول از تیمهای اقیانوسیه بالاتر است)، اینکه زمین بیطرف است یا نه، و اینکه بازی در جام جهانی است یا نه. کنفدراسیونها با روش one-hot کدگذاری شدهاند، یعنی برای هر کنفدراسیون یک ستون بله یا خیر. روی هم ۳۱ ویژگی.
نکته اصلی این است که همه اینها در یک گذر زمانی روی سابقه بازیها ساخته میشود: اول ویژگیهای پیش از بازی ثبت میشود، ردیف بازی اضافه میشود و فقط بعد از آن Elo، فرم و سابقه رودررو با نتیجه همان بازی بهروز میشود. پس برای ساخت ویژگیهای هر بازی فقط از بازیهای قبل از آن استفاده شده است.
زمین بازی. بیشتر بازیهای جام جهانی در زمین بیطرف برگزار میشود، اما کشور میزبان در خانه بازی میکند. سیستم این را با یک قرارداد صریح در نظر میگیرد. بازی در زمین بیطرف متقارن حساب میشود (میانگین هر دو ترتیب تیمها)، و در بازی کشور میزبان، ۱۲۵٫۵۸ امتیاز Elo به میزبان اضافه میشود. این عدد یک بار روی سابقه پیش از جام ۲۰۲۶ برآورد شده است، پس در ارزیابی جامهای گذشته دادههایی را هم در بر دارد که شامل همان جامهاست. همین قرارداد روی Elo هم اعمال میشود تا هیچکدام از دو سیستم اطلاعاتی نداشته باشد که دیگری ندارد. وقتی این عدد را برای هر جام فقط روی دادههای پیش از همان جام دوباره برآورد کردم (۱۳۰٫۲، ۱۲۸٫۶ و ۱۲۷٫۸ امتیاز)، log-loss مدل ترکیبیمدل ترکیبیمدلی که برای هر نتیجه، احتمال XGBoost را با وزن ۷۵ درصد و احتمال Elo را با وزن ۲۵ درصد ترکیب میکند. اپ همین احتمال را نشان میدهد.دیدن در واژهنامه کمتر از ۰٫۰۰۰۱ تغییر کرد و دقت Elo به اندازه یک بازی. پس این انتخاب روی هیچکدام از نتیجههای بعدی اثری ندارد.
مدل: XGBoost، برآورد Elo و وزنی که حفظ شد
مدل طبقهبندی اصلی XGBoost است (چن و گوئسترین، ۲۰۱۶)، روشی از خانواده تقویت گرادیان (gradient boosting) که صدها درخت تصمیم کوچک را پشت سر هم میسازد و هر درخت خطای درختهای قبلی را اصلاح میکند. مدل با تابع هدف softmax سهکلاسه و تنظیمات معمول برای دادههای جدولی آموزش میبیند: درختهایی با عمق ۵، نرخ یادگیری ۰٫۰۵، زیرنمونهگیری، min_child_weight برابر ۳ و حداکثر ۱۰۰۰ درخت با توقف زودهنگام. برای توقف زودهنگام، آخرین بازیهای داده آموزشی کنار گذاشته میشوند و آموزش وقتی متوقف میشود که نتیجه روی این بازیها دیگر بهتر نشود. چیز عجیبی در این تنظیمات نیست؛ تصمیمهای جالب بعد از آن میآیند.
اولین تصمیم این بود که XGBoost خام را مستقیم استفاده نکنم. احتمالهایی که مدلهای درختی تقویتشده میدهند ممکن است بهطور سیستماتیک با فراوانی واقعی نخوانند (نیکولسکومیزیل و کاروانا، ۲۰۰۵)، و برای مدلی که کل خروجیاش احتمال است، این مهم است. پس احتمالهای XGBoost را با یک برآورد اولیه بر پایه Elo (prior) ترکیب کردم؛ برآوردی ساده و پایدار که مدل یادگیرنده را به سمت خودش میکشد. این برآورد همان فرمول امتیاز مورد انتظار بالاست: سهم ثابت d برای تساوی کنار گذاشته میشود و بقیه بر اساس انتظار Elo بین دو تیم تقسیم میشود:
و احتمال نهایی، ترکیب این دو احتمال است:
یعنی در احتمال نهایی، XGBoost وزن ۷۵ درصد و برآورد Elo وزن ۲۵ درصد دارد.
درباره وزن ۰٫۷۵. پیشنویس قبلی این مقاله این وزن را حاصل یک جستوجو برای پیدا کردن بهترین وزن روی دو جام جهانی قدیمیتر معرفی میکرد. بازبینی پیش از انتشار این جستوجو را با روش ارزیابی نهایی دوباره اجرا کرد، فقط روی جامهای ۲۰۰۶ و ۲۰۱۰ (۱۲۸ بازی) و کاملاً بیرون از سه جامی که برای ارزیابی کنار گذاشته شده بود. نتیجه این بود که جستوجو بهترین وزن مشخصی پیدا نمیکند. log-loss کل از Elo خالص (۰٫۹۴۳) تا XGBoost خالص (۰٫۹۰۷) تقریباً یکنواخت پایین میآید، کل منحنی کمتر از یک خطای استاندارد بوتاسترپ با کمینهاش فاصله دارد و دو جام درباره جای کمینه با هم توافق ندارند. وزن ۰٫۷۵ فقط ۰٫۰۰۵ بالاتر از کمینه است، یعنی کاملاً درون همان خطا. طبق قاعدهای که از قبل تعیین کرده بودم (وزن فعلی میماند، مگر اینکه جستوجو وزن بهروشنی بهتری پیدا کند)، وزن ۰٫۷۵ را نگه داشتم. ترکیب با Elo انتخاب نهایی را در بازیهای کمی عوض میکند (۲ بازی از ۱۹۲ بازی، در مقایسه با XGBoost خام)؛ کارش هموار کردن احتمالهاست و بخش ارزیابی نشان میدهد که این کار را انجام میدهد.
سادهسازی دوم این است که برآورد Elo سهم تساوی را ثابت و برابر ۰٫۲۲۷ میگیرد، یعنی سهم تساوی در کل سابقه پردازششده. احتمال تساوی در واقع ثابت نیست: در بازی دو تیم همسطح بیشتر و در بازیهای نابرابر کمتر است. اگر داور کار خودم بودم، اول از همه به همین انتخاب ایراد میگرفتم. یک نکته هم باید همینجا گفته شود. این عدد از کل سابقه تا ژوئن ۲۰۲۶ محاسبه شده، پس وقتی در ارزیابی جامهای ۲۰۱۴، ۲۰۱۸ و ۲۰۲۲ به کار میرود، بازیهای بعد از آن جامها را هم در بر دارد. Elo این مشکل را ندارد: سهم تساویاش برای هر جام از بازیهای پیش از همان جام برآورد میشود و در هر سه جام نزدیک به ۰٫۲۲۷ درمیآید. با روش ارزیابی اولم، وقتی همین عددهای هر جام را در مدل ترکیبی گذاشتم، log-loss کل حدود 3 × 10⁻⁶ تغییر کرد و دقت تغییری نکرد. این بررسی را با روش ارزیابی نهایی تکرار نکردم و هیچ نتیجهای در این مقاله به آن وابسته نیست. مدلی که احتمال تساوی را یاد بگیرد همچنان بالای فهرست کارهای بعدی من است.
ارزیابی روی سه جام جهانی گذشته
ارزیابی را روی جامهای جهانی ۲۰۱۴، ۲۰۱۸ و ۲۰۲۲ انجام دادم، به روشی که در انگلیسی به آن walk-forward backtestارزیابی روی جامهای گذشته (walk-forward backtest)مدل فقط با بازیهای پیش از یک جام آموزش میبیند، روی همان جام آزموده میشود و بعد همین کار برای جام بعدی تکرار میشود؛ درست مثل اینکه پیشبینی در همان زمان انجام شده باشد.دیدن در واژهنامه میگویند: مدل فقط با بازیهای پیش از یک جام آموزش میبیند، روی همان جام آزموده میشود و بعد همین کار برای جام بعدی تکرار میشود. برای هر جام، یک مدل تازه با بازیهای پیش از اولین بازی آن جام آموزش دیده است. (مدل روی قدیمیترین ۹۰ درصد این بازیها آموزش میبیند و ۱۰ درصد آخر برای انتخاب نقطه توقف زودهنگام کنار گذاشته میشود.) امتیاز، فرم و سابقه رودررو تیمها هم در همان نقطه ثابت میماند و مدل فقط روی همان جام آزموده میشود. مثلاً مدل ۲۰۱۸ هیچ بازیای از ژوئن ۲۰۱۸ به بعد ندیده و تصویرش از هر تیم همان تصویری است که شب پیش از بازی افتتاحیه داشت. مدل مبنا قاعده ساده Elo است: تیمی که امتیاز بالاتری دارد برنده پیشبینی میشود، احتمالها از فرمول Elo میآیند و قرارداد زمین بازی هم همان است. سه جام روی هم ۱۹۲ بازی است.
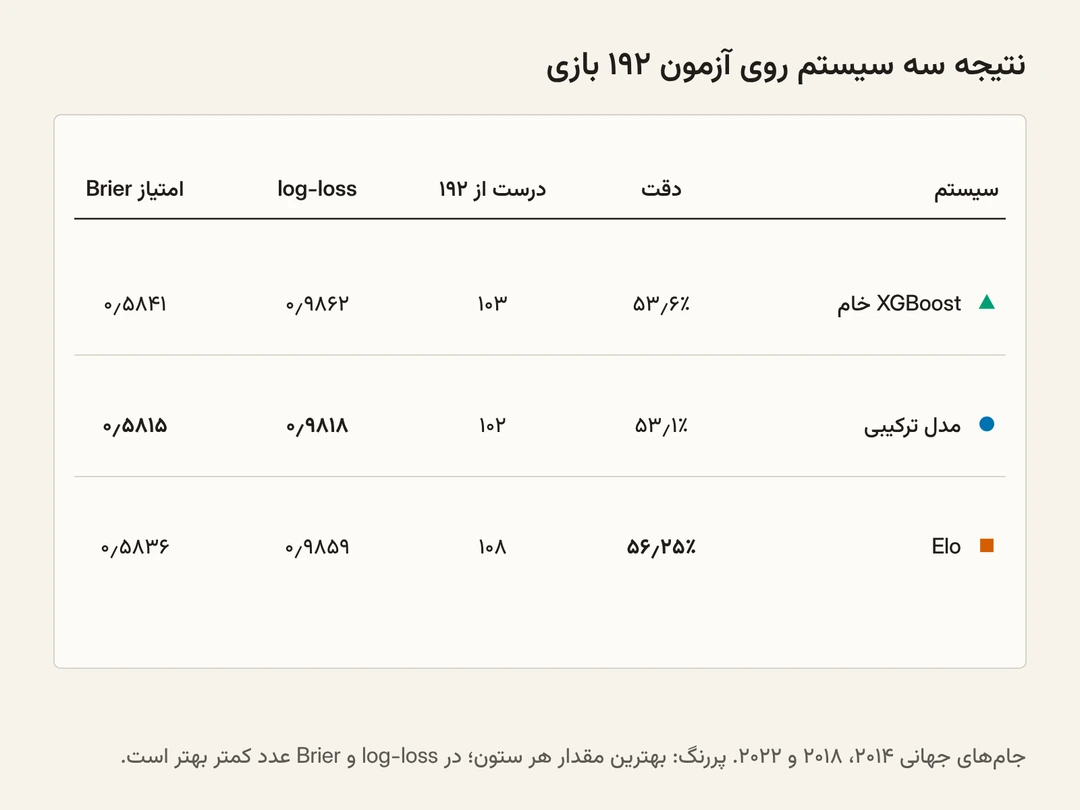
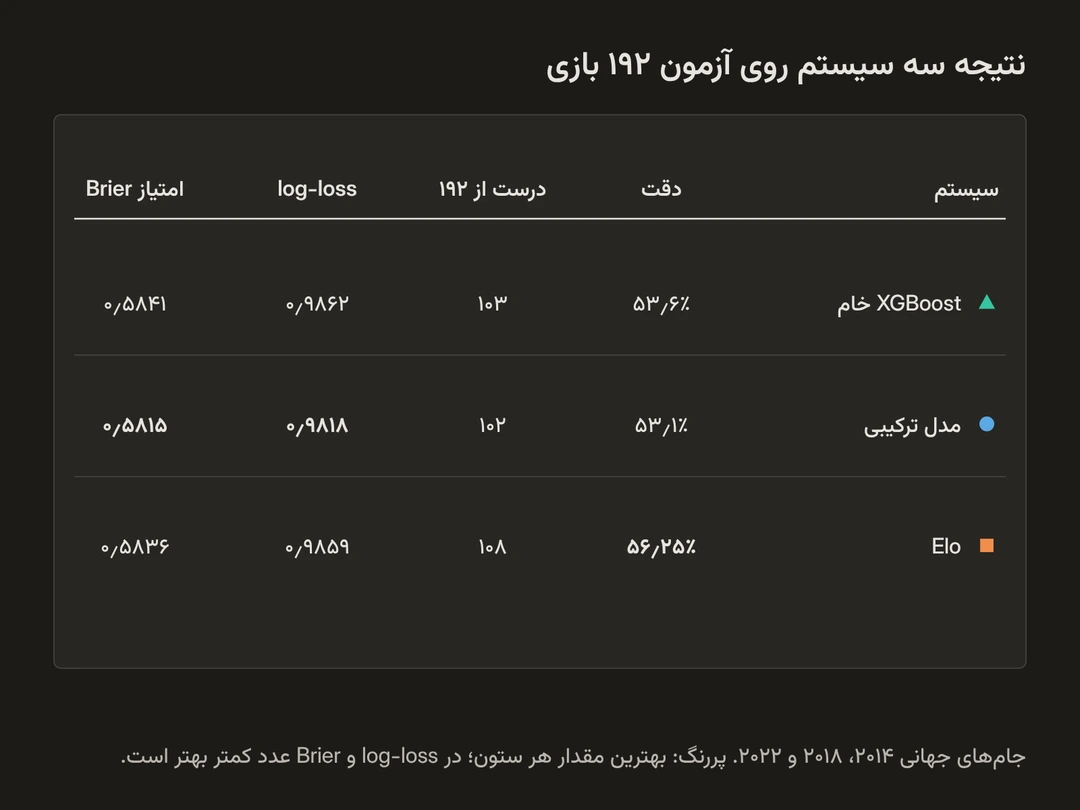
دو تا از این عددها نیاز به تعریف دارند. فرض کنید پیشبینی به نتیجهای که واقعاً رخ داد احتمال p داده است. log-loss میانگین −ln p روی همه بازیهاست. امتیاز Brierامتیاز Brierبرای هر بازی، مربع خطای احتمال هر سه نتیجه جمع زده میشود و امتیاز، میانگین این جمع روی همه بازیهاست. عدد کمتر بهتر است.دیدن در واژهنامه برای هر بازی مربع خطای احتمال هر سه نتیجه را جمع میکند و بعد میانگین این جمع را روی همه بازیها میگیرد:
هر دو معیار به پیشبینی مطمئن و درست امتیاز خوب میدهند و پیشبینی مطمئن و غلط را جریمه میکنند. هر دو وقتی کمترین مقدار را دارند که احتمالها واقعیترین برآورد مدل باشند. برای همین است که در مدلی که خروجیاش احتمال است، به این دو معیار بیشتر از دقت تکیه میکنم.
مدل ترکیبی در دقت از Elo جلو نمیزند. مدل مبنای ساده از ۱۹۲ بازی، شش بازی را بیشتر درست پیشبینی کرد. اولین واکنشم ناامیدی بود. واکنش دوم و بهترم این بود که بپرسم: آیا اختلاف دقت ۳٫۱ واحد درصد روی ۱۹۲ بازی اصلاً واقعی است؟
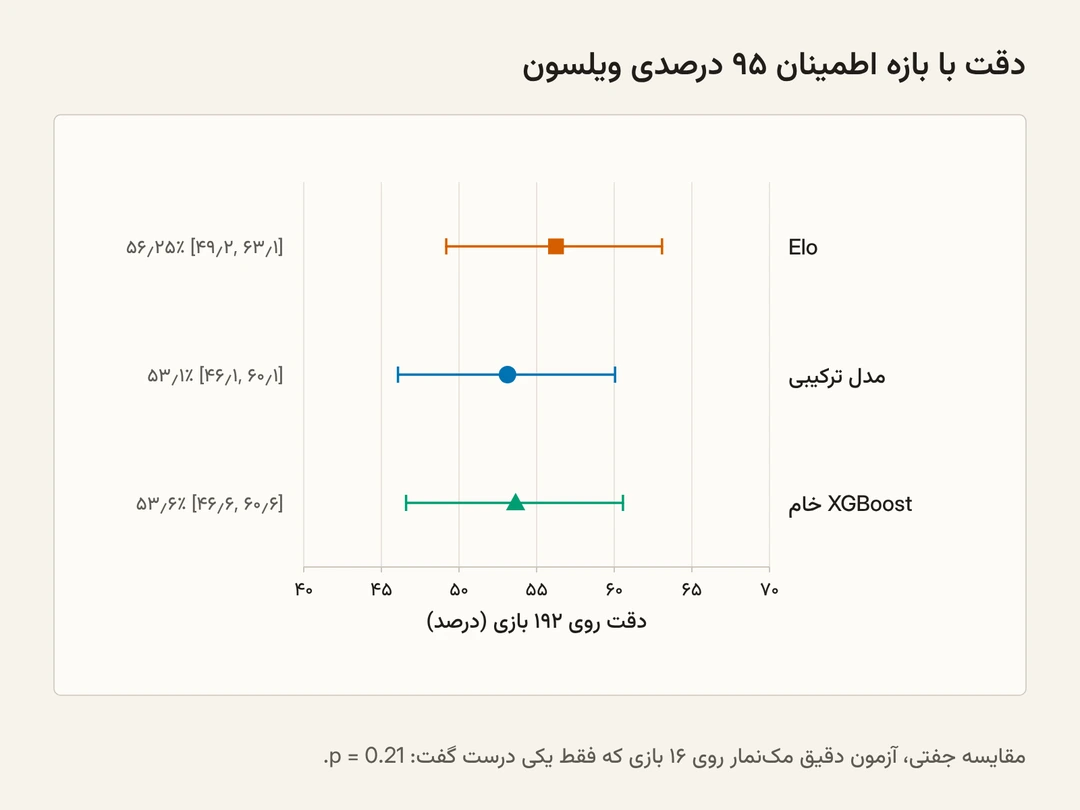
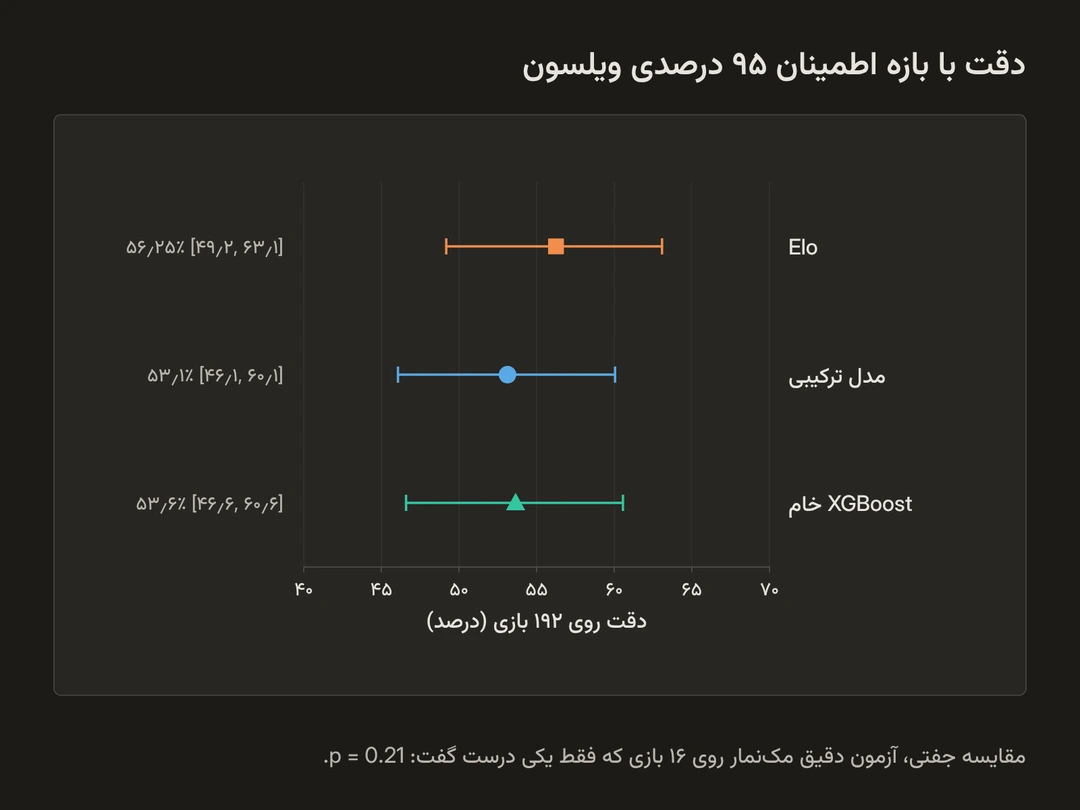
چون هر دو سیستم روی همان بازیها سنجیده میشوند، مقایسه جفتی است و ابزار درست آزمون مکنمارآزمون مکنمار (McNemar's test)آزمونی جفتی که فقط بازیهایی را میشمارد که یکی از دو مدل نتیجه را درست پیشبینی کرده و دیگری اشتباه کرده است، و میپرسد آیا یکی بیش از حد انتظار از روی شانس جلو افتاده است.دیدن در واژهنامه (McNemar's test) است، نه آزمونی که دو نمونه مستقل را مقایسه میکند. آزمون مکنمار فقط بازیهایی را میشمارد که یکی از دو مدل نتیجه را درست پیشبینی کرده و دیگری اشتباه کرده است، و میپرسد آیا یکی از دو مدل بیش از حد انتظار از روی شانس جلو افتاده است. از ۱۹۲ بازی، مدل ترکیبی و Elo در ۱۷ بازی نتیجه متفاوتی پیشبینی کردند. در یکی از آنها (روسیه و کرواسی در ۲۰۱۸) هر دو اشتباه کردند. در ۱۶ بازی دیگر فقط یکی درست گفت: ۵ بار مدل ترکیبی و ۱۱ بار Elo، یعنی Elo در مجموع شش بازی جلو بود. آزمون دقیق دوطرفه مکنمار روی این ۱۶ بازی p = 0.21 میدهد؛ یعنی آزمون جفتی تفاوت معناداری در دقت پیدا نکرد.
احتمالها تصویر کمی متفاوتی نشان میدهند. برای سنجش تفاوت log-loss از بوتاسترپ جفتی (paired bootstrap) استفاده کردم. از میان همان ۱۹۲ بازی، هزاران نمونه ۱۹۲تایی گرفتم. در هر نمونه، یک بازی ممکن بود چند بار انتخاب شود. هر دو مدل را روی همان نمونه مقایسه کردم. تفاوت log-loss هر بازی (مدل ترکیبی منهای Elo) به طور میانگین −0.004 و به نفع مدل ترکیبی است، اما بازه ۹۵ درصدی آن [−0.025, +0.018] است و بهراحتی صفر را در بر میگیرد. به زبان ساده: این آزمون هیچ شاهد آماری معناداری نمیدهد که یکی از دو سیستم بهتر است.
پس نه میشود گفت «Elo مدل مرا شکست داد» و نه «مدل من Elo را شکست داد». ادعای قابل دفاع این است: دقت مدل ترکیبی از Elo کمتر بود، اما این تفاوت از نظر آماری معنادار نبود. log-loss و امتیاز Brier مدل ترکیبی هر دو کمی پایینتر بود، و بازه ۹۵ درصدی تفاوت log-loss صفر را در بر میگرفت.
دو نکته هم اینجا لازم است. اول، این مقایسه منصفانه است: مدل ترکیبیای که روی جامهای گذشته آزموده شد دقیقاً همان روشی را اجرا میکند که اپ استفاده میکند، با همان احتمالهای متقارن، همان قرارداد زمین بازی و همان سهم ثابت تساوی. نسخه خوشنماتری نیست که برای نوشتن مقاله تنظیم شده باشد. دوم، با اینکه وزن ترکیب فقط روی جامهای ۲۰۰۶ و ۲۰۱۰ انتخاب شد، در طول کار نتایج ۲۰۱۴، ۲۰۱۸ و ۲۰۲۲ را دیده بودم. پس این آزمون را باید ارزیابیای با نگاه به گذشته دانست، نه آزمونی نهایی روی دادهای که هرگز دیده نشده. در بخش نتایج جام ۲۰۲۶، چهار پیشبینی ثبتشده پیش از بازی را جدا از ۱۰۰ پیشبینی بازسازیشده بررسی میکنم.
روش ارزیابی چه چیزی را عوض کرد
عددهای بالا آنهایی نیستند که اول به دست آوردم. در ارزیابی اولم، امتیاز، فرم و سابقه رودررو هر تیم در طول همان جامی که ارزیابی میشد، بازی به بازی بهروز میشد؛ پس مدلی که یکچهارم نهایی را پیشبینی میکرد، میدانست در مرحله گروهی چه گذشته است. هیچ نتیجهای از آینده وارد داده آموزشی نشده بود، اما فرم تیمها در طول جام به ویژگیهای «پیش از بازی» دورهای بعد راه پیدا کرده بود. سیستم واقعی اینطور کار نمیکند: شب فینال، وضعیت تیمها در مدل همان وضعیت پیش از بازی افتتاحیه است، بهعلاوه هر چه از آن زمان ثبت شده باشد؛ و در نسخه ثابتی که اپ از آن استفاده میکند، هیچ چیزی ثبت نمیشود.
بعد از اصلاح این مشکل (برای هر جام یک نسخه ثابت از وضعیت تیمها پیش از جام، یعنی همان شرایطی که اپ واقعاً در آن کار میکند) و اضافه شدن قرارداد زمین بازی، همه عددها تغییر کرد. دقت مدل ترکیبی از ۵۶٫۲۵ درصد به ۵۳٫۱ درصد رسید و دقت Elo از ۵۷٫۸ درصد به ۵۶٫۲۵ درصد. این عدم تقارن مهم است: تغییر روش ارزیابی، روی هم، دقت مدلی را که از ویژگیهای فرم اخیر استفاده میکند حدود دو برابر Elo پایین آورد. اگر همان فرم درون جام چیزی باشد که این ویژگیها از آن استفاده میکردند، دقیقاً همین انتظار میرود. چون ثابت ماندن وضعیت تیمها و قرارداد زمین بازی همزمان تغییر کردند، این مقایسه سهم هر کدام را جدا نمیکند. قرارداد زمین بازی، که روی هر دو سیستم اعمال شد، پیشبینی بازیهای کشور میزبان را هم سختتر کرد، چون در این سه جام میزبانهایی که شانس برد بیشتری داشتند، بیشتر از حد انتظار باختند. و تغییر p آزمون مکنمار از 0.58 به 0.21 نتیجه تغییر روش ارزیابی است، نه جمع شدن شواهد به سمت معناداری؛ نباید آن را یک روند دانست.
به تفکیک جام
وقتی عددهای کل را برای هر جام جدا میکنیم (هر جام ۶۴ بازی)، تصویر یکدست نیست، اما Elo در هر سه جام در دقت جلوتر است:
- ۲۰۱۴ (۶۴)
- مدل ترکیبی: دقت ۵۶٫۳٪, log-loss ۰٫۹۵۵۹, Brier ۰٫۵۶۸۸
- Elo: دقت ۵۹٫۴٪, log-loss ۰٫۹۶۵۱, Brier ۰٫۵۷۵۰
- XGBoost خام: دقت ۵۶٫۳٪, log-loss ۰٫۹۵۷۲, Brier ۰٫۵۶۹۵
- ۲۰۱۸ (۶۴)
- مدل ترکیبی: دقت ۵۳٫۱٪, log-loss ۰٫۹۵۷۵, Brier ۰٫۵۶۵۶
- Elo: دقت ۵۶٫۳٪, log-loss ۰٫۹۵۱۰, Brier ۰٫۵۶۲۵
- XGBoost خام: دقت ۵۳٫۱٪, log-loss ۰٫۹۶۷۴, Brier ۰٫۵۷۰۷
- ۲۰۲۲ (۶۴)
- مدل ترکیبی: دقت ۵۰٫۰٪, log-loss ۱٫۰۳۲۰, Brier ۰٫۶۱۰۲
- Elo: دقت ۵۳٫۱٪, log-loss ۱٫۰۴۱۶, Brier ۰٫۶۱۳۳
- XGBoost خام: دقت ۵۱٫۶٪, log-loss ۱٫۰۳۴۰, Brier ۰٫۶۱۲۱
نتیجه به تفکیک جام. log-loss و Brier کمتر مدل ترکیبی در ۲۰۱۴ و ۲۰۲۲ است؛ در ۲۰۱۸ Elo در هر سه معیار بهتر است. میانگین وزنی این ردیفها همان عددهای کل در شکل ۳ است.
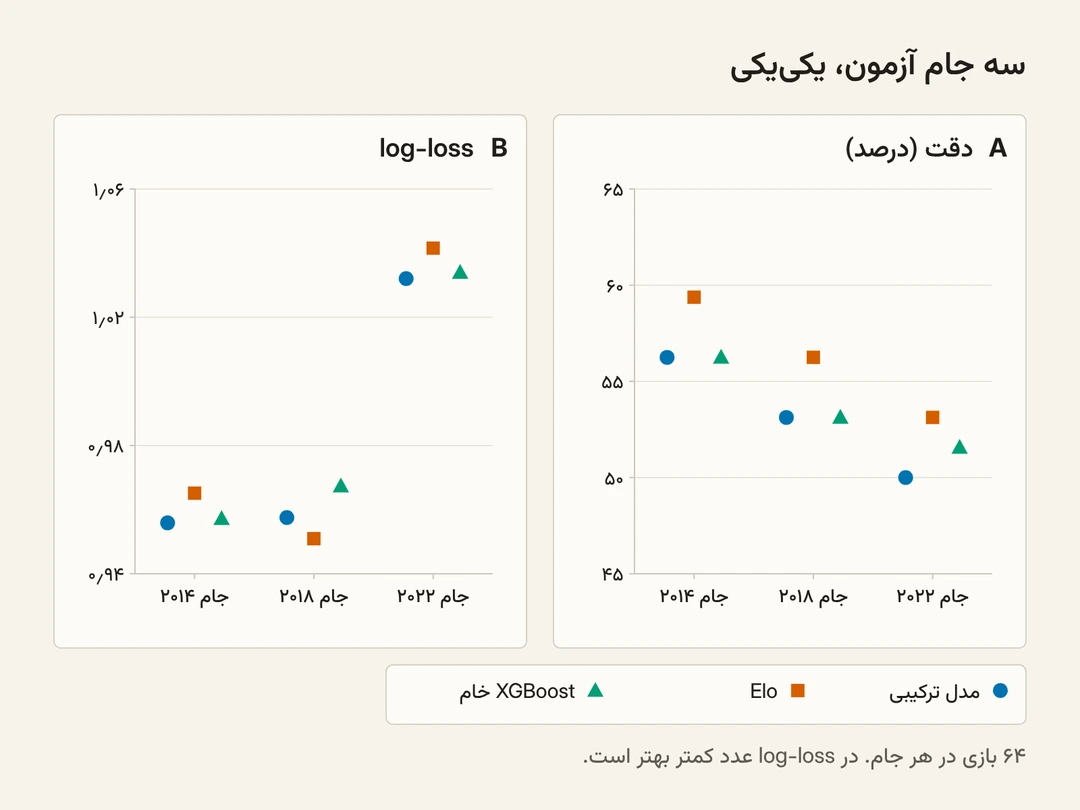
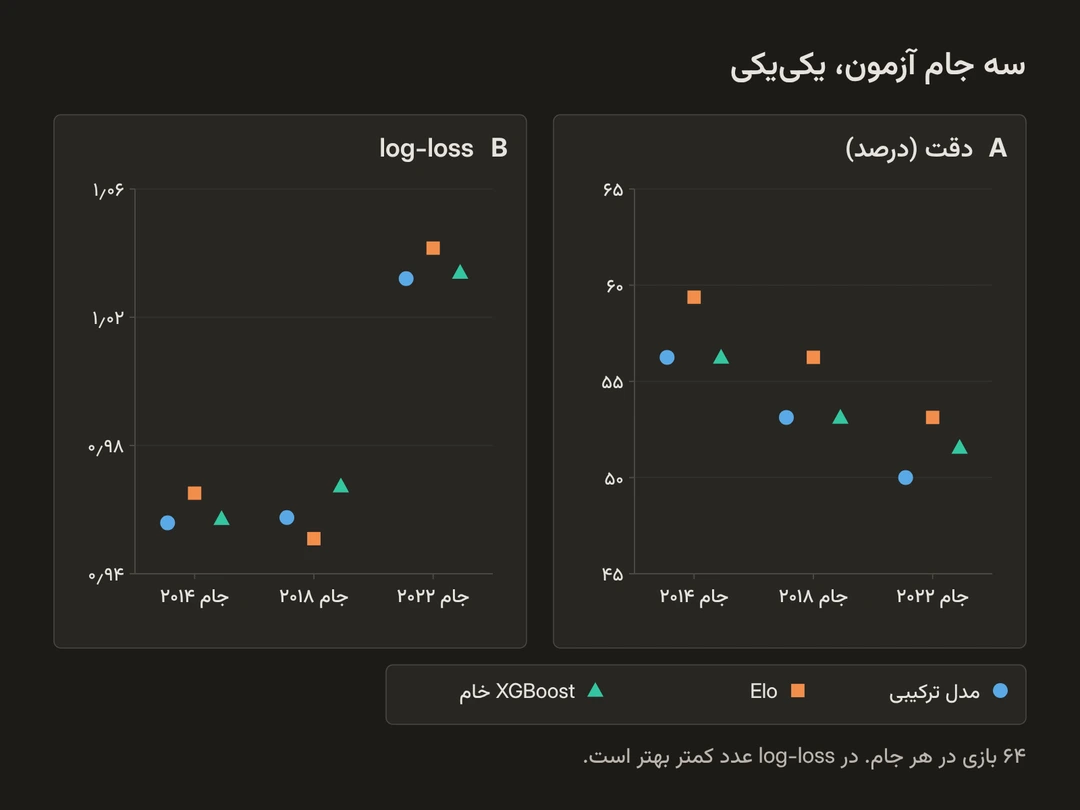
پس درباره احتمالها میشود گفت: log-loss و Brier کل مدل ترکیبی واقعاً کمتر است، اما این برتری به دو جام از سه جام تکیه دارد و بازه تفاوت log-loss صفر را در بر میگیرد؛ برای همین آن را برتری قابل اتکایی نمیدانم. این دو معیار کیفیت کلی پیشبینی را میسنجند و بهتنهایی حکمی درباره کالیبراسیونکالیبراسیون (calibration)اینکه احتمالهای اعلامشده با واقعیت بخواند: اگر مدل به تعداد زیادی بازی احتمال برد ۶۰ درصد بدهد، انتظار داریم حدود ۶۰ درصد آن بازیها به برد برسند. خطای کالیبراسیون مورد انتظار (expected calibration error یا ECE) فاصله این دو را اندازه میگیرد.دیدن در واژهنامه نیستند. کالیبراسیون (calibration) یعنی اینکه اگر به تعداد زیادی نتیجه احتمال ۶۰ درصد بدهیم، حدود ۶۰ درصد آنها واقعاً رخ بدهد. وقتی کالیبراسیون سه سیستم را مقایسه کردم (با معیار خطای کالیبراسیون مورد انتظار یا ECE، یعنی میانگین فاصله احتمال اعلامشده با فراوانی واقعی، روی احتمال محتملترین نتیجه و با ۱۰ بازه همعرض)، ترتیب همین بود: مدل ترکیبی ۰٫۰۴۰، XGBoost خام ۰٫۰۴۷ و Elo ۰٫۰۵۴؛ هر سه عدد روی ۱۹۲ بازی کوچکاند.
یک عدد دیگر هم هست. در این ۱۹۲ بازی ۴۱ تساوی رخ داد و هیچکدام از سه سیستم حتی یکی از آنها را پیشبینی نکرد. مدل ترکیبی و Elo در هیچ بازیای تساوی را محتملترین نتیجه ندانستند؛ XGBoost خام فقط یک بار تساوی را محتملترین نتیجه دانست (روسیه و اروگوئه در ۲۰۱۸) و آن بازی هم مساوی نشد. این درباره محتملترین نتیجه است، نه احتمال تساوی؛ هر سه سیستم همچنان به تساوی احتمالی میدهند. هیچکدام از این سیستمها تساوی را به شکل معناداری پیشبینی نمیکند. این ضعف شناختهشده مدلهای سهگزینهای فوتبال است و حالا، به جای اینکه در یک میانگین پنهان بماند، صریح ثبت شده است.
برای اینکه عددها معنای روشنتری پیدا کنند: log-loss حدس کاملاً تصادفی در سه نتیجه برابر ln 3 ≈ 1.099 است. هم مدل ترکیبی (۰٫۹۸۲) و هم Elo (۰٫۹۸۶) از آن بهترند، اما نه خیلی. امتیاز Brier برای احتمال برابر به هر سه نتیجه ۰٫۶۶۷ است و ۰٫۵۸ بهروشنی از آن بهتر است. پس هر دو سیستم واقعاً اطلاعات مفیدی میدهند و تقریباً به یک نقطه میرسند. این تقریباً مساوی شدن، یافته اصلی پروژه است: روی این آزمونِ جامهای گذشته، هیچکدام از چیزهایی که ساختم، با ویژگیهایی که از دادههای عمومی داشتم، بهطور معنادار بیشتر از یک امتیاز ساده Elo از دادهها بیرون نکشید. این با یافتههای پژوهشی (لاسک و همکاران، ۲۰۱۳؛ هواتوم و آرنتزن، ۲۰۱۰) همخوان است که نشان میدهند سیستمهای Elo مدلهای مبنای بهطرز چشمگیری قویای برای فوتبالاند. این را سقفی برای همه دادههای فوتبال نمیدانم؛ ۱۹۲ بازی برای چنین ادعایی کافی نیست. اما با دادهها و ویژگیهایی که داشتم، Elo رقیبی بود که باید شکستش میدادم، و بهترین نتیجهای که گرفتم این بود که در انتخاب نتیجه تفاوت قابل تشخیصی نداشتم و احتمالهایم کمی بهتر بود.
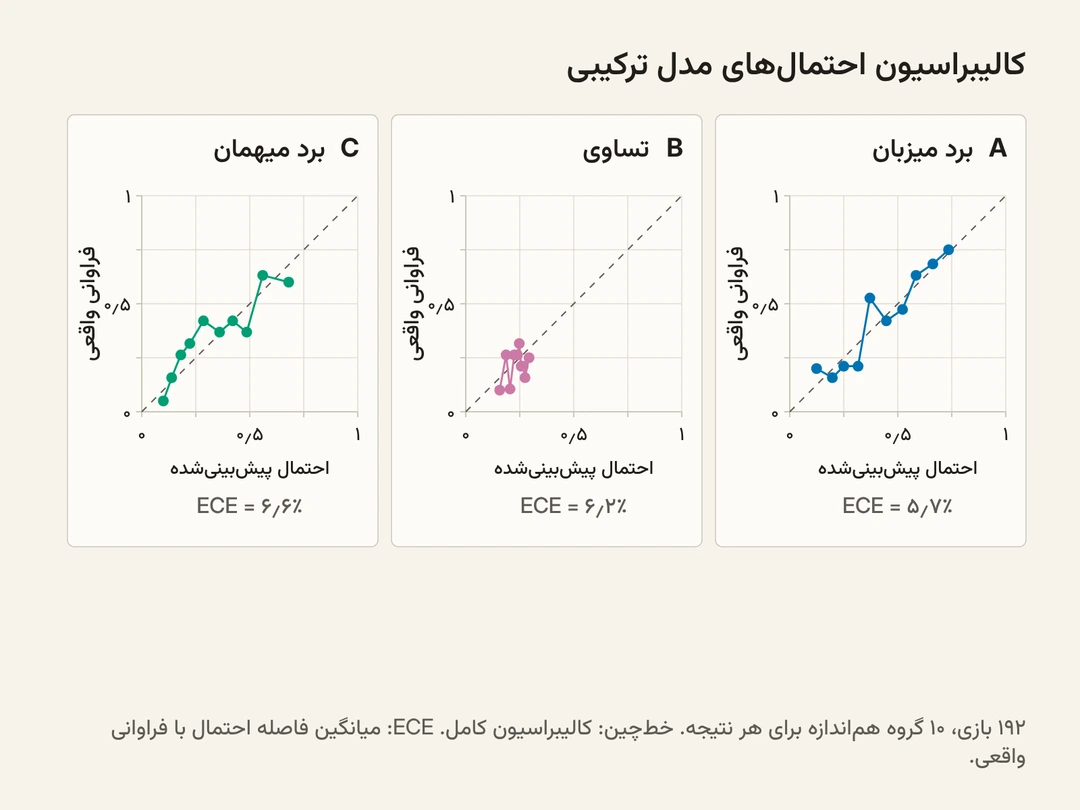
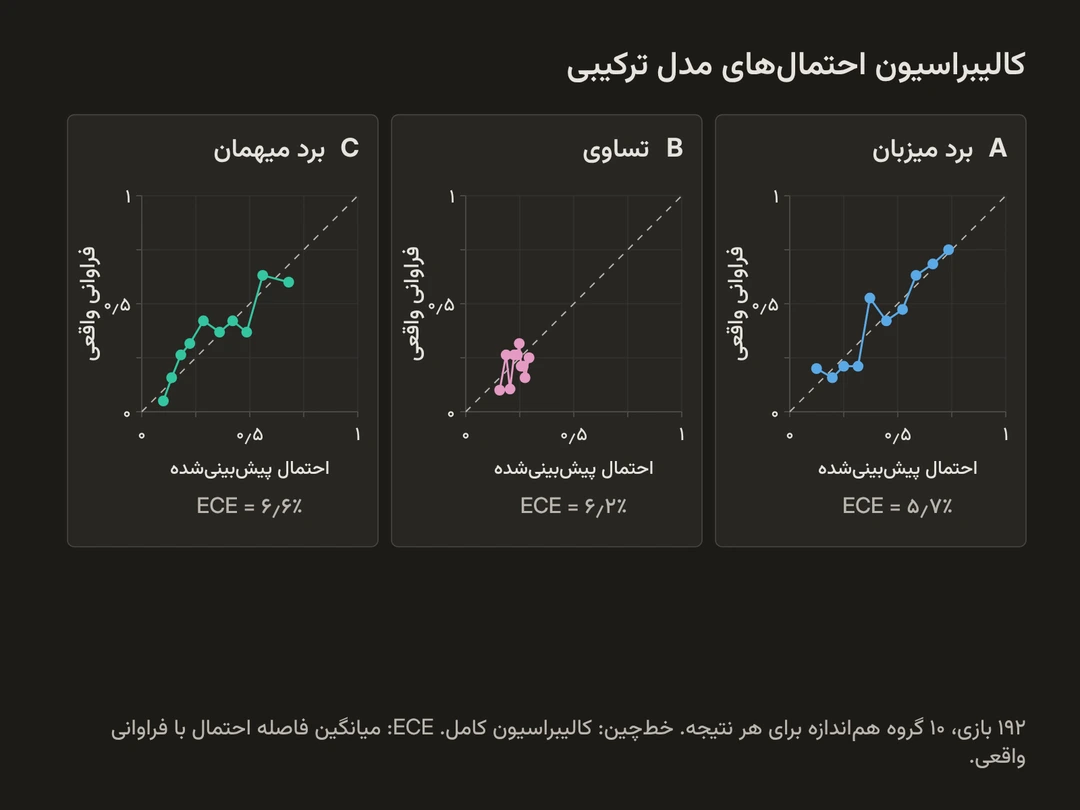
همه عددهای این بخش قابل بازتولیدند. پیشبینیهای هر بازی در این آزمون، خلاصههای هر جام و کل، آزمونهای جفتی، مقایسه دو روش ارزیابی، شکلها و هش دادهها در پوشه reports/ مخزن نگهداری میشوند.
پیشبینی تعداد گلها با مدل دیکسون و کولز، بدون تناقض با احتمالهای اصلی
مدل اصلی فقط احتمال برد، تساوی و باخت را میدهد. اما خیلیها میخواهند نتیجه دقیق را هم بدانند، پس با احتیاط این بخش را اضافه کردم. روش کلاسیک، گلهای هر تیم را با توزیع پواسون مدل میکند (توزیع معمول برای رویدادهایی که با نرخ میانگین ثابتی رخ میدهند؛ ماهر، ۱۹۸۲). دیکسون و کولزمدل دیکسون و کولز (Dixon and Coles model)مدلی برای پیشبینی نتیجه دقیق که گلهای هر تیم را با توزیع پواسون مدل میکند و چهار نتیجه کمگل (صفر بر صفر، یک بر صفر، صفر بر یک و یک بر یک) را، که گلهایشان مستقل از هم نیست، تصحیح میکند.دیدن در واژهنامه (Dixon and Coles) در ۱۹۹۷ این روش را با تصحیحی برای وابستگی گلها در بازیهای کمگل بهتر کردند. احتمال اینکه میزبان i گل و میهمان j گل بزند این است:
در این فرمول، جملههای پواسون گلهای هر تیم را مدل میکنند و تصحیح τ با پارامتر ρ احتمال چهار نتیجه کمگل (صفر بر صفر، یک بر صفر، صفر بر یک و یک بر یک) را به رفتار واقعی بازیهای کمگل نزدیک میکند.
تغییری که من دادم یک شرط سازگاری است. به جای اینکه یک مدل نتیجه دقیق جداگانه بسازم که ممکن است با احتمالهای روی صفحه نخواند، میانگین گل مورد انتظار هر تیم (λ_home, λ_away) را طوری پیدا میکنم که وقتی احتمال همه نتیجههای دقیق را جمع میزنیم، دوباره به همان احتمال برد، تساوی و باختی برسیم که روی صفحه نمایش داده شده است. تفاوت مجاز کوچک است: یک آزمون سریع خودکار بررسی میکند که این تفاوت از ۱٫۵ واحد درصد بیشتر نشود. محتملترین نتیجههای دقیق از همین جدول خوانده میشوند. پس سازگاری با احتمالهای اصلی تضمین شده است، نه اینکه به شانس سپرده شده باشد.
یک نکته: ρ یک بار با روش بیشینه درستنمایی روی همان داده ثابت برآورد شده (−0.0500 روی ۴۹٬۴۰۴ بازی) و به شکل عدد ثابت −0.05 به کار میرود. چون پیشبینی نتیجه دقیق فقط برای نمایش است و در هیچ ارزیابیای امتیاز نمیگیرد، این کار هیچ اطلاعاتی از آینده وارد عددهای گزارششده نمیکند.
SHAP کدام بخش پیشبینی را توضیح میدهد؟
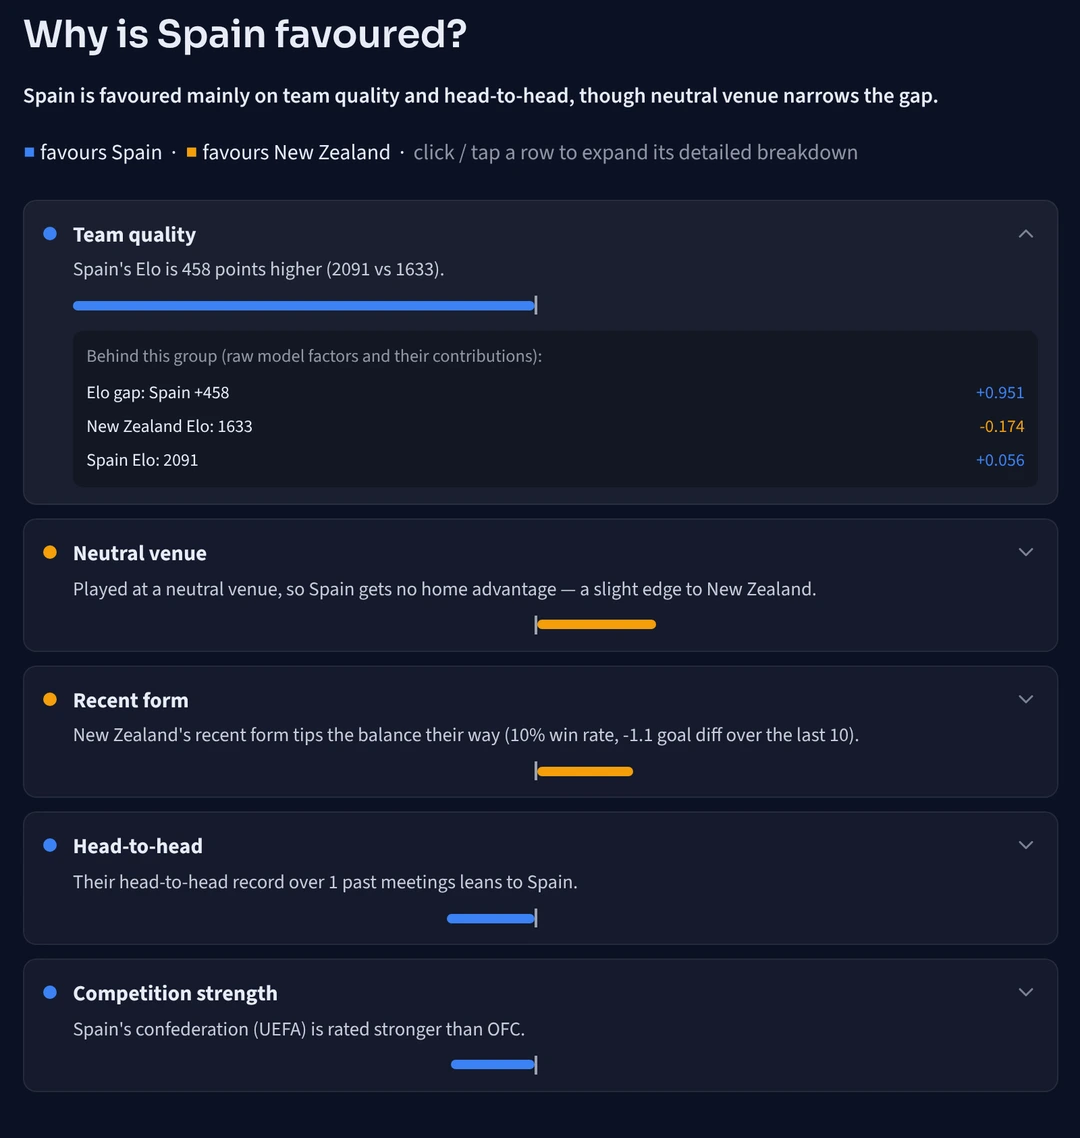
احتمالی که دلیلی پشتش نباشد سخت باور میشود. برای همین هر پیشبینی با یک توضیح به زبان ساده همراه است که بر پایه SHAPSHAPروشی که یک پیشبینی را به سهم هر ویژگی ورودی تقسیم میکند. اینجا نشان میدهد کدام عاملها امتیاز خام برد تیم اول را در XGBoost بالا یا پایین بردهاند.دیدن در واژهنامه ساخته شده است (لاندبرگ و لی، ۲۰۱۷). SHAP روشی است که یک پیشبینی را به سهم هر یک از ویژگیهای ورودی تقسیم میکند؛ اینجا با الگوریتم دقیق TreeSHAP برای مدلهای درختی محاسبه میشود (لاندبرگ و همکاران، ۲۰۲۰).
SHAP خروجی مدل را به شکل جمعپذیر بین ویژگیها تقسیم میکند. اما ۳۱ ویژگی، که چند تایشان ستونهای بله یا خیر کنفدراسیوناند، توضیحی شلوغ و نامفهوم میسازند. برای همین مقدارهای SHAP را در چند گروه ثابت و قابل فهم جمع میزنم: کیفیت تیم، فرم اخیر، قدرت رقابت، سابقه رودررو و زمین بیطرف. چون SHAP جمعپذیر است، جمع گروهها دقیقاً با چیزی که توضیح میدهند برابر است؛ یک آزمون سریع خودکار در هر بار اجرا این برابری را تا دقت 10⁻⁴ بررسی میکند.
یک توضیح لازم است. SHAP در اینجا بخش XGBoost را توضیح میدهد، نه احتمال نهایی روی کارت را. جمعپذیریاش هم در سطح امتیاز خام مدل (logit) است، نه در سطح احتمال. مدل برای هر نتیجه اول یک امتیاز خام حساب میکند: مقدار پایه بهعلاوه جمع سهم ویژگیها. بعد softmax این سه امتیاز را به احتمال تبدیل میکند. احتمال نهایی هم بعد از آن، با کشیدن این احتمالها یکچهارم راه به سمت برآورد Elo ساخته میشود. پس این بخش از اپ نشان میدهد چرا XGBoost به یک سمت متمایل است؛ تجزیه کامل احتمال نهایی نیست. توضیح بر اساس برد تیم اول تنظیم شده است، پس در یک بازی نزدیک، «امتیاز را پایین میآورد» لزوماً به معنای «به نفع تیم دیگر است» نیست و ممکن است به نفع تساوی باشد. یک توضیح دقیق برای سه نتیجه باید امتیاز محتملترین نتیجه را با نتیجه دوم مقایسه کند؛ این کار در فهرست کارهای بعدی است.
از یک بازی تا کل جام: شبیهسازی مونتکارلو
مدلی که یک بازی را پیشبینی میکند، با شبیهسازی مونتکارلوشبیهسازی مونتکارلو (Monte Carlo simulation)بازی کردن کل جام هزاران بار، که نتیجه هر بازی بهطور تصادفی از احتمالهای مدل برداشته میشود، و شمردن اینکه هر تیم چند بار به هر مرحله میرسد.دیدن در واژهنامه (Monte Carlo simulation) به مدلی برای کل جام تبدیل میشود؛ یعنی کل جام را بارها بازی میکنیم و نتیجه هر بازی را بهطور تصادفی از احتمالهای مدل برمیداریم. من کل جدول ۲۰۲۶ را هزاران بار بازی میکنم: ۱۲ گروه چهارتیمی و بعد کل مرحله حذفی، از یکشانزدهم نهایی (که در آن هشت تیم سوم برتر به تیمهای اول و دوم گروهها اضافه میشوند) تا فینال. در هر بار، نتیجه هر بازی را از احتمالهای مدل میگیرم و میشمارم هر تیم چند بار به هر مرحله میرسد و چند بار قهرمان میشود. در هر گروه، تیمها را اول با امتیاز، بعد با تفاضل گل کل، بعد با گل زده و بعد با نتیجه بازیهای رودررو بین تیمهای همامتیاز رتبهبندی میکنم؛ اگر باز هم مساوی بمانند، ترتیب بهطور تصادفی تعیین میشود. این ترتیب سادهسازی خود من است، نه ترتیب آییننامه: طبق مقررات رسمی ۲۰۲۶، تیمهای همامتیاز اول با نتایج رودررو از هم جدا میشوند و فقط بعد از آن تفاضل گل کل، گل زده، امتیاز بازی جوانمردانه و رتبه فیفا به کار میرود. معیارهایی که من در نظر گرفتهام تکلیف بیشتر گروهها را روشن میکنند، اما رتبهبندی داخل گروه را باید سادهشده دانست. در مقابل، جدول تخصیص تیمهای سوم دقیقاً از آییننامه گرفته شده است. بازیهای حذفیای که مساوی تمام شوند به ضربات پنالتی میروند و برنده پنالتیها هم بر اساس احتمالهای مدل تعیین میشود.
پیچیدهترین بخش یک جدول ۴۸ تیمی مرحله یکشانزدهم نهایی است. اینکه تیم سوم هر گروه به کدام جایگاه برود، در یک جدول رسمی (پیوست C آییننامه فیفا برای جام ۲۰۲۶) مشخص شده است: یک تخصیص برای هر کدام از C(12, 8) = 495 حالتی که هشت تیم سوم صعودکننده ممکن است داشته باشند. شبیهساز همین جدول را مستقیم پیاده میکند و هر ۴۹۵ ردیف را هنگام بارگذاری بررسی میکند: هر تیم سوم صعودکننده باید دقیقاً یک بار جا بگیرد، هیچ تیمی نباید در جایگاه غیرمجاز بنشیند و هیچ تیمی نباید دوباره به همگروهی خودش بخورد. پس چیدمان جدول طبق آییننامه درست است، نه فقط باورپذیر.
چون شبیهساز با احتمالها کار میکند، نه با انتخاب قطعی، کالیبراسیون مستقیم اثر دارد: احتمالهای بهتر برای هر بازی یعنی شانس قابل اعتمادتر برای هر تیم در کل جام.
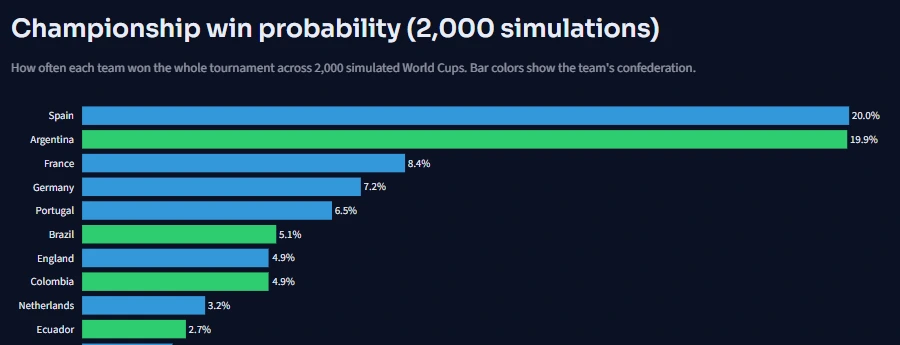
دو نسخه دیگر از این چشمانداز هم هست. شبیهسازی که در بخش بعد درباره بازبینیاش توضیح دادهام، با همان seed (عددی که دنباله انتخابهای تصادفی را ثابت نگه میدارد)، آرژانتین را کمی جلوتر میگذارد: ۲۰٫۱ درصد در برابر ۱۸٫۶ درصد برای اسپانیا. یک سند عمومی هم از پیش از جام وجود دارد: پستی در لینکدین (در زبانه تازه باز میشود) که ۱۱ ژوئن ۲۰۲۶ ساعت ۱۳:۵۵ به وقت UTC، پیش از شروع بازی افتتاحیه، منتشر شد و چشمانداز قهرمانی شبیهساز را همانطور که آن روز بود ثبت کرد (ده هزار اجرا، پیش از بازبینی): اسپانیا ۲۰٫۹ درصد، آرژانتین ۱۸٫۱ درصد، فرانسه ۸٫۲ درصد و برزیل ۷٫۸ درصد. این پست فقط زمان انتشار را بهطور عمومی ثبت میکند؛ پیشبینیای نیست که امتیاز گرفته باشد و در ارزیابی هم وارد نشده است.
اپ چطور پیشبینی میکند و بازبینی چه مشکلی پیدا کرد؟
مدلی که فقط روی لپتاپ من اجرا شود پروژه نیست. برای همین سیستم را مثل یک سرویس کوچک ساختم: اپی چهارصفحهای (پیشبین بازی، ردیاب پیشبینی، شبیهساز جام و رتبهبندی تیمها) که روی یک سرویس میزبانی عمومی اجرا میشود.
بخشی که بیش از همه برایم مهم است ردیاب پیشبینی (Prediction Tracker) است و مهمترین مشکلی که بازبینی پیش از انتشار پیدا کرد هم همینجا بود. تضمین مورد نظر ساده بود: هر پیشبینی برای یک بازی جام ۲۰۲۶ از مدل و نسخهای از وضعیت تیمها میآید که دادهاش پیش از شروع جام تمام شده است؛ پس مدل هیچ نتیجهای از جام ۲۰۲۶ ندیده است. مرز دادهها شروع جام است، نه پایان سال: دادههای آموزشی همه بازیهای ملی تا شب بازی افتتاحیه را در بر دارد (آخرین بازی در ۱۰ ژوئن ۲۰۲۶) و فقط بازیهای جام جهانی که پیشبینی میشوند کنار گذاشته شدهاند. یک نکته درباره تاریخها هم باید گفته شود: فایل مدلی که در این مقاله ارزیابی شده، ۱۳ ژوئیه ۲۰۲۶، یعنی در طول جام، از همان داده ثابت ساخته شده است و زمان ساخت و هشها در فایل manifest آن ثبت است. پس این مقاله میتواند درباره تاریخ پایان دادههای آموزشی ادعا کند، نه درباره اینکه همین فایل پیش از بازی افتتاحیه وجود داشته است. نتیجههای واقعی بازیها از یک سرویس داده فوتبال دریافت و با این پیشبینیها مقایسه میشود.
بازبینی نشان داد که اپ این تضمین را دقیق رعایت نمیکرد. هر بار که اپ بعد از مدتی بیاستفاده ماندن دوباره راه میافتاد، آخرین نسخه مجموعهداده را دانلود میکرد و مدل را از نو آموزش میداد. پس در طول جام، اپ عمومی با مدلی کار میکرد که روی نسخه کمی متفاوتی از داده آموزش دیده بود (یک ردیف بیشتر و نقطه توقف زودهنگام متفاوت)، نه با همان مدلی که در این مقاله ارزیابی شده است. هیچ نتیجهای از جام ۲۰۲۶ وارد دادههای آموزشیاش نشد، پس تضمین زمانی سر جایش ماند، اما «همان مدل» نبود. این مشکل برطرف شده است: نسخه ثابت مدل و دادههایی که اپ برای پیشبینی استفاده میکند حالا همراه هشهایشان در مخزن نگهداری میشوند، اپ به جای آموزش دوباره همینها را بارگذاری میکند و اگر هشی با manifest نخواند، هیچ پیشبینیای نشان نمیدهد.
نکته دوم به ثبت پیشبینیها پیش از بازی مربوط است. پیشبینیهایی که هر بار از دادههای ثابت دوباره حساب میشوند اطلاعاتی از آینده ندارند، اما ثابت نمیکنند که عدد مشخصی پیش از بازی مشخصی منتشر شده است. برای همین برای چهار بازی آخر جام یک دفتر ثبت پیشبینیها ساختم که فقط میشود به آن ردیف اضافه کرد (append-only). هر ردیف احتمالهای هر دو سیستم، محل بازی، هش مدل، نسخه کد و زمان ساخت پیشبینی را ثبت میکند و نشان میدهد که ردیف پیش از شروع بازی نوشته شده است. پیشبینی نیمهنهاییها ۱۳ ژوئیه و پیشبینی ردهبندی و فینال ۱۶ ژوئیه ثبت شد. این دفتر هرگز ویرایش نشده و ارزیابی از روی همین دفتر انجام میشود، نه از روی اپ. محدودیتش این است: هر ردیف زمان ساخت پیشبینی را به وقت UTC دارد، اما ساعت رسمی شروع بازی در آن ثبت نشده است؛ پس بررسی «پیش از شروع بازی» فقط تاریخها را مقایسه میکند، نه ساعتها را.
همه اینها را یک آزمون سریع پیش از push کنار هم نگه میدارد. این آزمون نسخه ثابت مدل و دادههای اپ را بارگذاری میکند (یک آزمون جداگانه هشهایشان را با manifest مقایسه میکند)، بررسی میکند که خروجیها احتمال معتبر باشند، تقارن پیشبینیها در زمین بیطرف را میسنجد، سازگاری جدول نتیجههای دقیق با احتمالهای اصلی را بررسی میکند، برابری جمع SHAP را میسنجد، جدول یکشانزدهم نهایی را بررسی میکند و یک شبیهسازی مونتکارلوی کوچک اجرا میکند. یک git hook هر push را که در این آزمون رد شود متوقف میکند و تا حالا چند خطای واقعی را پیش از انتشار گرفته است.
نتایج جام جهانی ۲۰۲۶
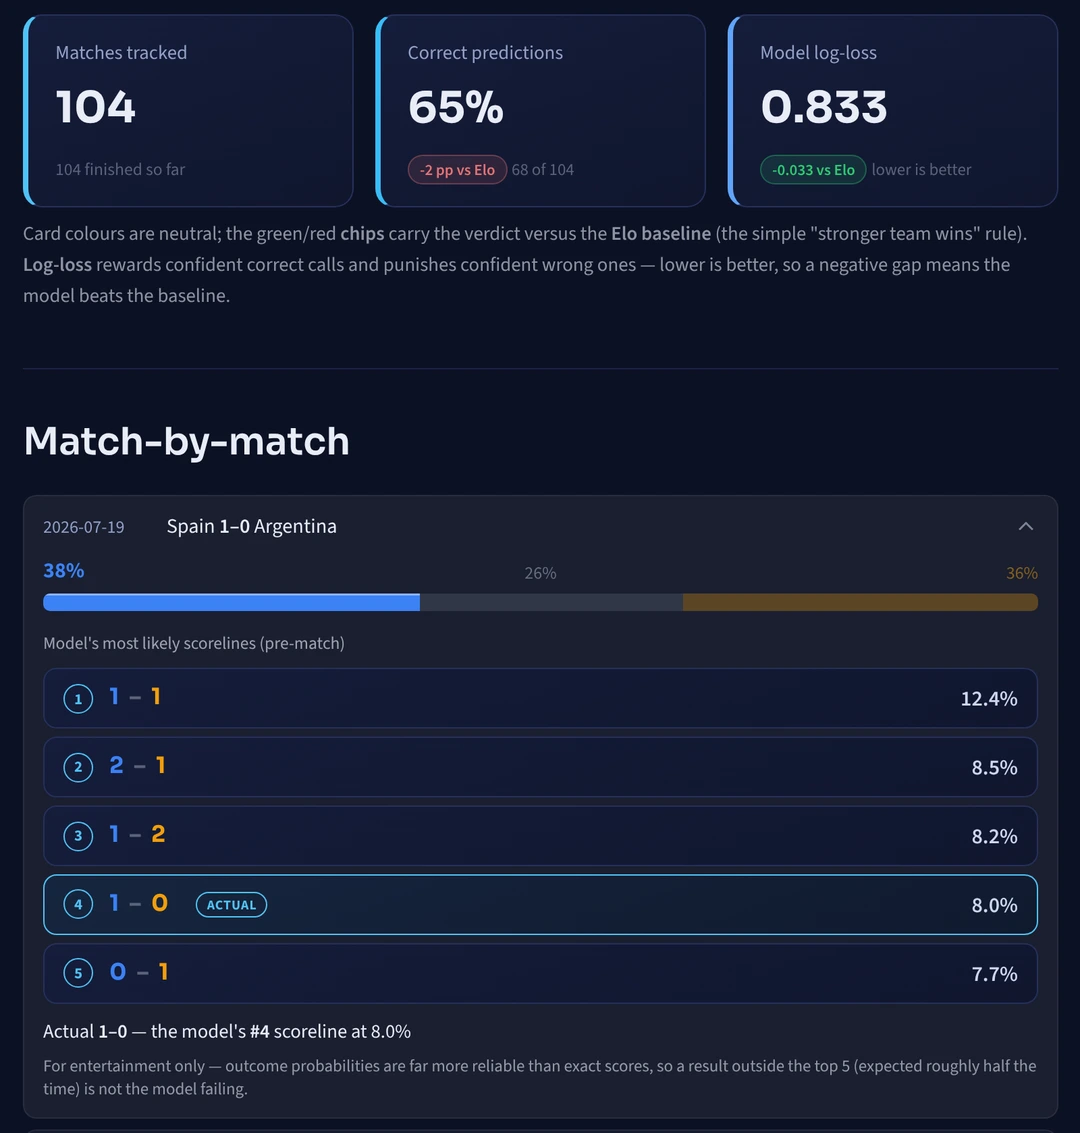
جام از ۱۱ ژوئن تا ۱۹ ژوئیه ۲۰۲۶ برگزار شد. اسپانیا در فینال آرژانتین را در وقت اضافه یک بر صفر برد و انگلیس در ردهبندی فرانسه را شش بر چهار شکست داد. هر ۱۰۴ بازی با همان قرارداد دادههای آموزشی امتیاز گرفتند (نتیجه بعد از وقت اضافه، با پنالتی به عنوان تساوی): ۹۵ بازی در وقت عادی تمام شد، ۵ بازی در وقت اضافه و ۴ بازی با ضربات پنالتی.
پیشبینیها دو گروهاند و نباید با هم یکی شوند.
چهار پیشبینی ثبتشده پیش از بازی
چهار ردیف دفتر تنها پیشبینیهای بازیبهبازیاند که واقعاً پیش از بازی ثبت شدهاند. مدل ترکیبی در نیمهنهاییها اسپانیا را به فرانسه و آرژانتین را به انگلیس ترجیح داد، در ردهبندی فرانسه را به انگلیس و در فینال اسپانیا را به آرژانتین. سه پیشبینی از چهار پیشبینی درست درآمد. تنها اشتباه بازی ردهبندی بود: مدل فرانسه را محتملتر میدانست، اما انگلیس شش بر چهار برد. Elo هم همان چهار تیم را ترجیح داده بود، پس در انتخاب نتیجه دو سیستم اینجا یکساناند. در این چهار بازی log-loss مدل ترکیبی ۰٫۸۹۲ بود و log-loss Elo ۰٫۸۷۰. با چهار بازی هیچ آزمونی معنا ندارد و این عددها را فقط برای کامل بودن گزارش میکنم.
۱۰۰ پیشبینی بازسازیشده بعد از جام
۱۰۰ پیشبینی دیگر با همان مدل ثابت و همان وضعیت ثابت تیمها ساخته شدهاند، اما بعد از جام، وقتی ارزیابی کامل را اجرا کردم، حساب شدهاند. این پیشبینیها به معنای دقیق کلمه روی دادهای ساخته شدهاند که مدل ندیده بود (هیچ نتیجهای از جام ۲۰۲۶ وارد دادههای آموزشی نشد؛ فقط بازیهای ملی تا ۱۰ ژوئن ۲۰۲۶ وارد شد)، اما پیش از بازی ثبت نشدهاند و خواننده حق دارد وزن کمتری به آنها بدهد. در این ۱۰۰ بازی، مدل ترکیبی نتیجه ۶۵ بازی و Elo نتیجه ۶۷ بازی را درست پیشبینی کرد.
نتیجه هر ۱۰۴ بازی
از ۱۰۴ بازی جام ۲۰۲۶، مدل ترکیبی نتیجه ۶۸ بازی (۶۵٫۴ درصد) و Elo نتیجه ۷۰ بازی (۶۷٫۳ درصد) را درست پیشبینی کرد. دو سیستم فقط در دو بازی انتخاب متفاوتی داشتند و هر دو بار Elo درست گفت؛ آزمون مکنمار p = 0.50 میدهد. در احتمالها، تصویر از آزمون جامهای گذشته روشنتر است: log-loss مدل ترکیبی ۰٫۸۳۳ بود و log-loss Elo ۰٫۸۶۷، امتیاز Brier هم ۰٫۴۸۷ در برابر ۰٫۵۰۷. بازه بوتاسترپ جفتی برای تفاوت log-loss هر بازی [−0.059, −0.005] است و صفر را در بر نمیگیرد. اگر فقط ۱۰۰ بازی بازسازیشده را در نظر بگیریم، این بازه [−0.063, −0.007] است.


پس آیا یافته آزمون جامهای گذشته در جام ۲۰۲۶ هم تکرار شد؟ در مهمترین بخشش، بله: مدل ترکیبی نتیجه بازیها را بهتر از امتیاز ساده Elo پیشبینی نکرد. هر دو سیستم در این جام دقیقتر از جامهای گذشته بودند (حدود ۶۵ درصد در برابر ۵۳ تا ۵۶ درصد)، که بیشتر درباره خود جام ۲۰۲۶ چیزی میگوید تا درباره مدلها: تیمهایی که شانس برد بیشتری داشتند، بیشتر بردند. تفاوت در کیفیت احتمالهاست. برتری مدل ترکیبی در log-loss، که در آزمون جامهای گذشته از صفر قابل تشخیص نبود، اینجا بزرگتر بود و بازهاش صفر را در بر نمیگرفت. این را دلگرمکننده میدانم، نه قطعی: فقط یک جام است و ۱۰۰ پیشبینی از ۱۰۴ پیشبینیاش بعد از جام بازسازی شده، نه پیش از بازی ثبت. آنچه این مقایسه نشان میدهد همین مشاهده است: در این ۱۰۴ بازی، مدل ترکیبی با انتخابهایی تقریباً یکسان، log-loss کمتری از Elo داشت. در بخش مدل گفتم که کشیدن احتمالهای XGBoost به سمت برآورد Elo باید احتمالها را بهتر کند، اما این مقایسه، که بین مدل ترکیبی و Elo است، نمیتواند این علت را جدا کند.
محدودیتها و کارهای بعدی
ضعفها را در طول متن گفتهام؛ اینجا همه را یکجا میآورم، تقریباً به ترتیبی که سراغشان میرفتم.
- مدلی که احتمال تساوی را یاد بگیرد. فرض من این است که سهم ثابت ۰٫۲۲۷ برای تساوی به مدل ترکیبی آسیب میزند و اینکه هیچ تساویای پیشبینی نشد نشانه همین است؛ اما هنوز آزمایشی نکردهام که اثر این انتخاب را جدا بسنجد. اولین آزمایشی که انجام میدادم این بود که احتمال تساوی با اختلاف قدرت دو تیم تغییر کند، همانطور که در مدلهای پواسون و دیکسون و کولز بهطور طبیعی تغییر میکند.
- Eloای که اهمیت بازی را در نظر بگیرد. K ثابت ۴۰ در نظر نمیگیرد که یک بازی جام جهانی باید امتیازها را بیشتر از یک بازی دوستانه تغییر دهد. اگر K با اختلاف گل و اهمیت بازی تغییر کند، خود مدل مبنا قویتر و منصفانهتر میشود.
- ارزیابی بزرگتر. ۱۹۲ بازی برای تشخیص برتری دو یا سه واحد درصدی کافی نیست و ۱۰۴ بازی جام ۲۰۲۶ هم فقط یک جام است. میشود همین آزمون را به بازیهای ملی بیشتری گسترش داد: هر بار مدل با بازیهای قبلی آموزش ببیند و روی بازیهای بعدی آزموده شود.
- ثبت پیشبینیها از بازی اول. دفتر ثبت پیشبینیها باید از ۱۱ ژوئن شروع میشد و هم زمان ثبت هر پیشبینی و هم ساعت رسمی شروع بازی را نگه میداشت؛ نه اینکه از ۱۳ ژوئیه و بدون ساعت شروع بازیها شروع شود.
- ویژگیهای بیشتر. دادههای سطح بازیکن (کیفیت ترکیب تیم، غیبت بازیکنان کلیدی) و فرمی که قدرت حریف را هم در نظر بگیرد، منبعهای روشنی از اطلاعاتاند که مدل فعلی، که فقط دادههای عمومی را میبیند، به آنها دسترسی ندارد.
یافته اصلی، در یک جمله:
روی آزمون ۱۹۲ بازی از سه جام جهانی گذشته و روی ۱۰۴ بازی جام جهانی ۲۰۲۶، مدل ترکیبی XGBoost و Elo نتیجه بازیها را بهتر از امتیاز ساده Elo پیشبینی نکرد و آزمونهای جفتی در هیچکدام تفاوت معناداری در دقت پیدا نکردند. احتمالهایش کمی بهتر بود: در آزمون جامهای گذشته فقط در عدد، چون بازه بوتاسترپ صفر را در بر میگرفت، و در جام ۲۰۲۶ روشنتر، چون بازه صفر را در بر نمیگرفت.
این آن برد تمیزی نیست که اول کار میخواستم. اما چیزی را نشانم داد: در جام جهانی، با دادههای عمومی، معمولاً تیمی میبرد که امتیاز بالاتری دارد؛ یک مدل پیچیدهتر بیشتر همین را دوباره کشف میکند و در بهترین حالت احتمالهای کمی بهتری میدهد؛ و یک مدل خوب باید همین را بگوید و روشن کند که چقدر ممکن است اشتباه کند.
کد و داده
کد، گزارشهای ارزیابی، نسخه ثابت مدل و دادههای اپ همراه هشهایشان، دفتر ثبت پیشبینیها، پیشبینیهای هر بازی در آزمون جامهای گذشته و جام ۲۰۲۶ و شکلهای این مقاله در مخزن عمومی پروژه (در زبانه تازه باز میشود) است. اپ پژوهشی (در زبانه تازه باز میشود) همان مدل ثابت را اجرا میکند؛ اگر مدتی کسی از اپ استفاده نکرده باشد، باز شدنش ممکن است چند دقیقه طول بکشد. خلاصه این کار در صفحه پروژه آمده است.
واژهنامه
- امتیاز Elo
- نمرهای برای قدرت نسبی هر تیم که از شطرنج آمده است. هر تیم از ۱۵۰۰ شروع میکند و بعد از هر بازی، امتیازش بر اساس فاصله نتیجه واقعی با نتیجه مورد انتظار تغییر میکند؛ پس حتی تساوی هم میتواند امتیاز را جابهجا کند.
- XGBoost
- روشی از یادگیری ماشین که صدها درخت تصمیم کوچک را پشت سر هم میسازد و هر درخت خطای درختهای قبلی را اصلاح میکند.
- برآورد اولیه بر پایه Elo (prior)
- برآوردی از احتمال برد، تساوی و باخت بر اساس امتیاز Elo دو تیم. در این پروژه، این برآورد ۲۵ درصد وزن پیشبینی نهایی را دارد.
- مدل ترکیبی
- مدلی که برای هر نتیجه، احتمال XGBoost را با وزن ۷۵ درصد و احتمال Elo را با وزن ۲۵ درصد ترکیب میکند. اپ همین احتمال را نشان میدهد.
- کالیبراسیون (calibration)
- اینکه احتمالهای اعلامشده با واقعیت بخواند: اگر مدل به تعداد زیادی بازی احتمال برد ۶۰ درصد بدهد، انتظار داریم حدود ۶۰ درصد آن بازیها به برد برسند. خطای کالیبراسیون مورد انتظار (expected calibration error یا ECE) فاصله این دو را اندازه میگیرد.
- log-loss
- معیاری برای پیشبینیهای احتمالی که پیشبینی مطمئن و درست را تشویق و پیشبینی مطمئن و غلط را بیشتر جریمه میکند. عدد کمتر بهتر است.
- امتیاز Brier
- برای هر بازی، مربع خطای احتمال هر سه نتیجه جمع زده میشود و امتیاز، میانگین این جمع روی همه بازیهاست. عدد کمتر بهتر است.
- ارزیابی روی جامهای گذشته (walk-forward backtest)
- مدل فقط با بازیهای پیش از یک جام آموزش میبیند، روی همان جام آزموده میشود و بعد همین کار برای جام بعدی تکرار میشود؛ درست مثل اینکه پیشبینی در همان زمان انجام شده باشد.
- بازه اطمینان (confidence interval)
- بازهای که عدمقطعیت یک برآورد را نشان میدهد. در این مقاله، اگر بازه اختلاف دو مدل صفر را در بر بگیرد، دادهها با نبود اختلاف هم سازگارند.
- بازه اطمینان ویلسون (Wilson interval)
- گستره دقتهای واقعیای که با تعداد پیشبینیهای درست سازگار است، اینجا با اطمینان ۹۵ درصد.
- آزمون مکنمار (McNemar's test)
- آزمونی جفتی که فقط بازیهایی را میشمارد که یکی از دو مدل نتیجه را درست پیشبینی کرده و دیگری اشتباه کرده است، و میپرسد آیا یکی بیش از حد انتظار از روی شانس جلو افتاده است.
- مقدار p (p-value)
- اگر دو مدل واقعاً دقت یکسانی داشته باشند، احتمال اینکه در آزمون اختلافی به این بزرگی یا بزرگتر ببینیم. در این مقاله از آزمون مکنمار به دست آمده است.
- بوتاسترپ جفتی (paired bootstrap)
- هزاران بار از همان بازیها با بازگرداندن نمونه میگیریم؛ یک بازی ممکن است در یک نمونه چند بار تکرار شود. هر بار هر دو مدل روی همان نمونه مقایسه میشوند تا ببینیم اختلاف امتیازشان چقدر تغییر میکند. در این مقاله، بازه تفاوت log-loss دو مدل را با این روش حساب کردم.
- مدل دیکسون و کولز (Dixon and Coles model)
- مدلی برای پیشبینی نتیجه دقیق که گلهای هر تیم را با توزیع پواسون مدل میکند و چهار نتیجه کمگل (صفر بر صفر، یک بر صفر، صفر بر یک و یک بر یک) را، که گلهایشان مستقل از هم نیست، تصحیح میکند.
- SHAP
- روشی که یک پیشبینی را به سهم هر ویژگی ورودی تقسیم میکند. اینجا نشان میدهد کدام عاملها امتیاز خام برد تیم اول را در XGBoost بالا یا پایین بردهاند.
- شبیهسازی مونتکارلو (Monte Carlo simulation)
- بازی کردن کل جام هزاران بار، که نتیجه هر بازی بهطور تصادفی از احتمالهای مدل برداشته میشود، و شمردن اینکه هر تیم چند بار به هر مرحله میرسد.
منابع
- Brier, G. W. (1950). Verification of forecasts expressed in terms of probability (در زبانه تازه باز میشود). Monthly Weather Review, 78(1), 1–3.
- Brown, L. D., Cai, T. T., and DasGupta, A. (2001). Interval estimation for a binomial proportion (در زبانه تازه باز میشود). Statistical Science, 16(2), 101–133.
- Chen, T., and Guestrin, C. (2016). XGBoost: A scalable tree boosting system (در زبانه تازه باز میشود). In Proceedings of the 22nd ACM SIGKDD (pp. 785–794).
- Dixon, M. J., and Coles, S. G. (1997). Modelling association football scores and inefficiencies in the football betting market (در زبانه تازه باز میشود). Journal of the Royal Statistical Society: Series C, 46(2), 265–280.
- Elo, A. E. (1978). The Rating of Chessplayers, Past and Present. Arco Publishing.
- Fédération Internationale de Football Association. (2026). Regulations: FIFA World Cup 26 (11 June to 19 July 2026) (در زبانه تازه باز میشود), including Annexe C, the round-of-32 combination table. FIFA.
- Forrest, D., Goddard, J., and Simmons, R. (2005). Odds-setters as forecasters: The case of English football (در زبانه تازه باز میشود). International Journal of Forecasting, 21(3), 551–564.
- Gneiting, T., and Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation (در زبانه تازه باز میشود). Journal of the American Statistical Association, 102(477), 359–378.
- Goddard, J., and Asimakopoulos, I. (2004). Forecasting football results and the efficiency of fixed-odds betting (در زبانه تازه باز میشود). Journal of Forecasting, 23(1), 51–66.
- Hvattum, L. M., and Arntzen, H. (2010). Using ELO ratings for match result prediction in association football (در زبانه تازه باز میشود). International Journal of Forecasting, 26(3), 460–470.
- Jürisoo, M. International football results from 1872 to present (در زبانه تازه باز میشود) [Data set]. GitHub. (نسخه ثابتی که برای این پروژه نگه داشته شد، با آخرین بازی در ۱۰ ژوئن ۲۰۲۶؛ هش فایل خام، داده پردازششده و مدل آموزشدیده در
models/model-manifest.jsonمخزن پروژه ثبت شده است). - Lasek, J., Szlávik, Z., and Bhulai, S. (2013). The predictive power of ranking systems in association football (در زبانه تازه باز میشود). International Journal of Applied Pattern Recognition, 1(1), 27–46.
- Lundberg, S. M., and Lee, S.-I. (2017). A unified approach to interpreting model predictions (در زبانه تازه باز میشود). NeurIPS 30. arXiv:1705.07874
- Lundberg, S. M., et al. (2020). From local explanations to global understanding with explainable AI for trees (در زبانه تازه باز میشود). Nature Machine Intelligence, 2(1), 56–67.
- Maher, M. J. (1982). Modelling association football scores (در زبانه تازه باز میشود). Statistica Neerlandica, 36(3), 109–118.
- Niculescu-Mizil, A., and Caruana, R. (2005). Predicting good probabilities with supervised learning (در زبانه تازه باز میشود). In Proceedings of the 22nd ICML (pp. 625–632).
- World Football Elo Ratings, methodology (در زبانه تازه باز میشود).
قالب جام و جدول تخصیص مرحله یکشانزدهم نهایی (پیوست C) طبق آییننامه رسمی مسابقات است (FIFA، ۲۰۲۶)؛ رتبهبندی داخل گروه در شبیهساز سادهسازیای است که در بخش شبیهسازی مونتکارلو توضیح داده شده است.
یادداشت درباره ابزارها: تحلیل، مدلسازی، کد، ارزیابی و نتیجهگیریهای این مقاله کار خود من است. برای ساختار و ویرایش متن از یک دستیار هوش مصنوعی کمک گرفتم و هر کلمه با تأیید نهایی من منتشر شده است.